
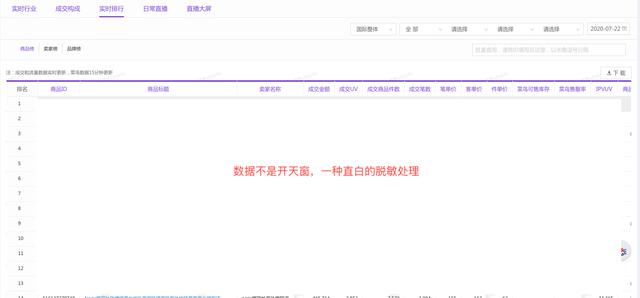
天猫国际营销活动分析实时排名是帮助商家快速分析商家或品牌在促销中的成交和流量数据,为下一步促销的销售目标、流量存储等做出运营决策;尤其是活动当天,发现行业内的问题,仅仅通过细分行业的拆分来确定具体问题是不够的,不一定有具体的业务把握,需要有商家、品牌、商品粒度的数据来快速定位问题。
原技术方案的架构如下图所示。可以看出是非常典型的Lambda架构。实时和离线系统分别是两套。离线数据通过MaxCompute(原MaxCompute)稍微聚合同步到MySQL,实时增量数据通过Blink清理后同步到HBase。最后,实时和离线数据在数据服务中以视图的形式结合起来,对外提供服务。
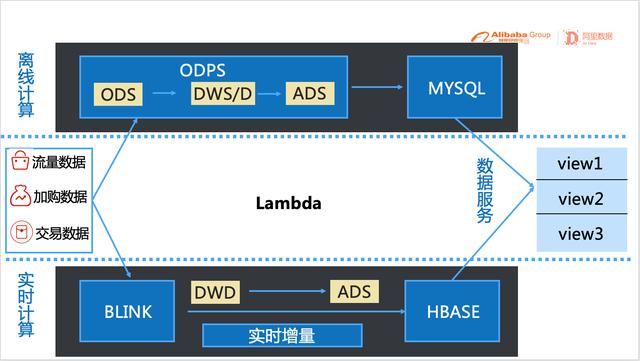
整个架构在实际业务实现中会有很多痛点,典型的如下:
1)ADS层模型有许多任务。
流和批处理任务都需要分别基于商品、卖家和品牌粒度开发三个ADS模型数据和三个数据同步任务,需要创建三个oneservice服务来满足三个数据模块的应用。
2)计算过程数据膨胀
在营销活动分析的场景下,看数据是基于天猫的国际业务类型和行业。因此,在离线和实时计算任务中,我们通常会并行计算不同bu类型和所有行业粒度的数据,这导致了计算过程中的大量数据膨胀。
3)流量批量分离
目前产品根据时间选择读取实时数据还是离线数据。三天内的数据是实时任务计算的,三天前的历史数据是批量任务计算的离线数据。有两组任务同时运行,增加了运维的复杂度。
4)复杂的产品构建逻辑
每个产品展示的报表模块需要通过实时数据提供的os接口和离线数据提供的os来进行。产品搭建的工作量比较大。用时间来判断什么时候读取离线os的数据,什么时候读取实时os的数据比较复杂。
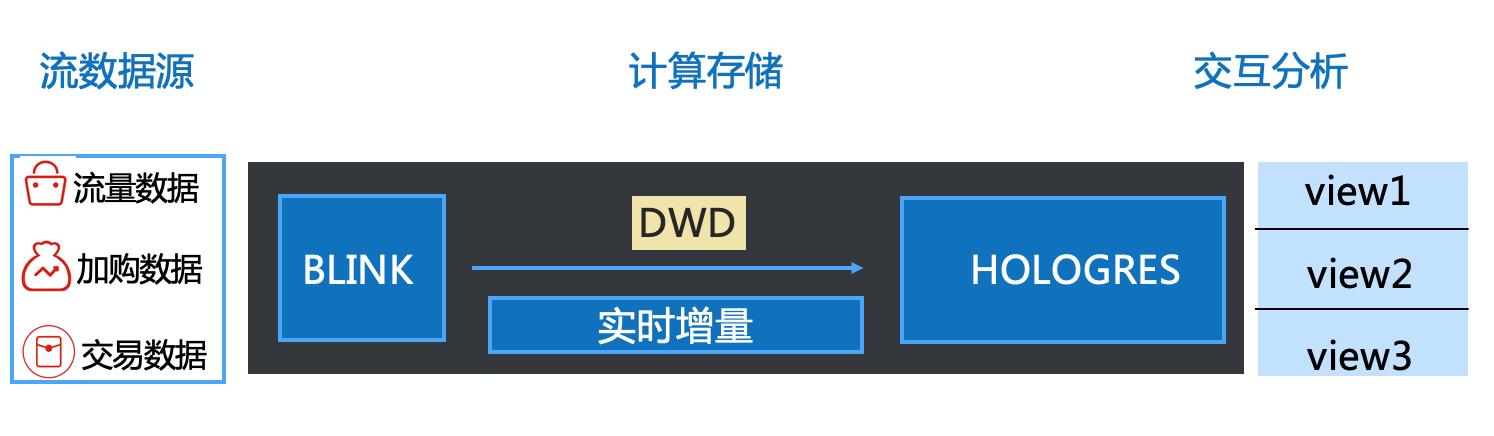
三.架构升级思考策略思考:为了提高R&D和产品构建的效率,我们只需要开发详细数据到DWD层,详细数据只需要存储叶子类别,在交互层次层根据需要关联行业维度表,提供外部随机查询服务,从而节省构建ADS层多个模型数据和数据服务接口的时间,在产品构建中基于一个数据接口满足多个不同应用场景的数据服务,提高产品质量。
策略:我们希望有一个产品,能够统一计算和编写任务,实现流量和批量的统一,对外提供免费的交互查询服务。
在产品技术选型之前,需要整理业务需要的表格和数据量,选择几个有代表性的表格,验证产品在实际业务场景下的技术可行性,验证关键指标的性能,包括查询QPS、编写TPS等。主要选择的表格和数据量如下:
(1)交易明细数据表
| buyer _ id+item _ id+order _ id | | 2019 11 | 4800 w | | 2020 06 18 | 600 w | | 2020 07 21 | 300 w |(2)流量IPV
| Visitor _ ID+item _ ID | | 2019 11 11 | 2.1亿| | 2020 06 18 | 7000 w | | 2020 07 21 | 2600 w |在技术选择上,我们锁定了两款产品。ADB是阿里云数据库事业部团队提供的云原生数据仓库AnalyticDB MySQL版本,是阿里巴巴自主研发的面向海量数据实时高并发在线分析的云计算服务。ho roles是阿里云计算平台事业部提供的实时交互分析产品,全面兼容PostgreSQL协议,与大数据生态无缝对接。从实际的业务场景来看,两者的主要区别如下:
1)与MaxCompute的连接
ho roles:使用MaxCompute,可以直接从外部表中读取MaxCompute数据进行查询分析,无需存储即可查询。
ADB:可以加快MaxCompute的查询速度,提供复杂交互分析、实时混合数据仓库等场景。
2)成本方面
对比亚行和ho roles每年的单价,ho roles的成本略低于亚行。
3)灵活性
都可以满足OLAP场景,ho roles兼容PostgreSQL生态,ADB稳固兼容MySQL协议,都可以满足实时和离线批量数据导入和分析。
4)性能
以下是Hologers的测试性能。数据量和大小基于MaxCompute的存储格式,没有任何特殊的索引和优化。
|数据量|测试项目|响应时间 | 4600 w(20.64 GB)| sum | 2.7s | 2300 w(5.04 GB)| sum | 1.1s | 4600 w(20.64 GB)| COUNT COUNT | 1.0s | 4600 w(5.04 GB)| COUNT(distinct)| 2.8s | 2300 w(5.04 GB)
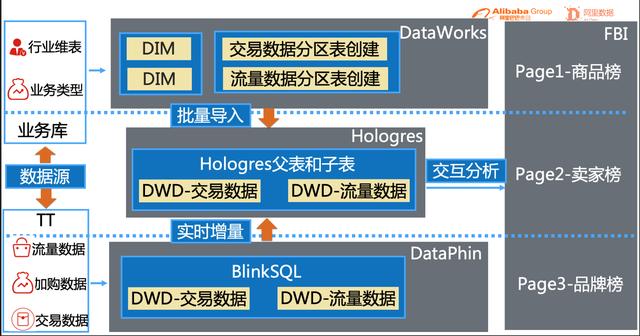
五.技术架构升级使用ho roles后的架构如下图所示。
升级技术架构后,主要有以下优势:
1。统一计算
商品、卖家、品牌粒度页面的数据由实时计算任务统一计算,计算过程中不关联行业、业务BU类型的维度表,根据需要在交互分析端按商品ID、叶子类别ID查询相关维度表。提高了R&D的效率,降低了运维的难度,并且没有实现计算任务的扩展,节省了计算资源。
2。存储统一
实时写入的交易和流水明细数据以ho roles统一的内部分区表形式存储,提供统一的数据管理和维护,通过统一存储实现同一数据库之间的任何交互分析和查询服务。
3。服务统一
并且产品、卖家、品牌粒度页面可以通过带有占位符的通用FBI数据集实现,数据可视化通过FBI报表方式实现,提高了产品构建的效率。
六.Hologres实战下面将描述ho roles在实时排行榜中的具体练习过程:
1。表格构建模型的设计
第一个是表格设计。合理的表设计可以大大提高查询效率,尤其是当数据量较大时,相关索引的选择和配置对性能优化起着非常重要的作用。所以在Hologres中创建表格之前,一定要想清楚表格的使用场景和查询逻辑。
在这个方案中,由于需要按照产品、卖家、品牌粒度汇总、流量数据来加入与交易相关的明细数据,还需要按照行业、bu类型进行搜索,主要使用的表DDL如下:
SQL 如果不存在则创建表public . dwd _ intl _ TRD _ pay _ ITM _ buyer _ ri( stat _ date text NOT null ,stat_hour text not null ,bu_id_level1 text not null ,bu_id_level2 text not null ,item_id text not null ,item_title text ,item 调用SET _ TABLE _ PROPERTY(& # 39;public . dwd _ intl _ TRD _ pay _ ITM _ buyer _ ri & # 39;, '方向& # 39;, '专栏& # 39;); 调用set _ table _ property(& # 39;public . dwd _ intl _ TRD _ pay _ ITM _ buyer _ ri & # 39;, '存储格式& # 39;, '细分& # 39;); 调用set _ table _ property(& # 39;public . dwd _ intl _ TRD _ pay _ ITM _ buyer _ ri & # 39;, 'segment _ key & # 39, '统计日期,统计小时,业务部门标识,业务部门标识级别1,业务部门标识级别2,分类标识& # 39;); 调用set _ table _ property(& # 39;public . dwd _ intl _ TRD _ pay _ ITM _ buyer _ ri & # 39;, 'distribution _ key & # 39, 'stat_date,stat _ hour & # 39); 调用set _ table _ property(& # 39;public . dwd _ intl _ TRD _ pay _ ITM _ buyer _ ri & # 39;, 'shard_count ',' 30 & # 39;); 如果不存在则创建表public . dwd _ intl _ log _ ipv _ ITM _ visitor _ ri( stat _ date text NOT null ,stat_hour text not null ,bu_id text not null ,bu_id_level1 text not null ,bu_id_level2 text not null ,item_id text not null ,item_title 调用SET _ TABLE _ PROPERTY(& # 39;public . dwd _ intl _ log _ ipv _ ITM _ visitor _ ri & # 39;, '方向& # 39;, '专栏& # 39;); 调用set _ table _ property(& # 39;public . dwd _ intl _ log _ ipv _ ITM _ visitor _ ri & # 39;, '存储格式& # 39;, '细分& # 39;); 调用set _ table _ property(& # 39;public . dwd _ intl _ log _ ipv _ ITM _ visitor _ ri & # 39;, 'segment _ key & # 39, '统计日期,统计小时,业务部门标识,业务部门标识级别1,业务部门标识级别2,分类标识& # 39;); 调用set _ table _ property(& # 39;public . dwd _ intl _ log _ ipv _ ITM _ visitor _ ri & # 39;, 'distribution _ key & # 39, 'stat_date,stat _ hour & # 39); 调用set _ table _ property(& # 39;public . dwd _ intl _ log _ ipv _ ITM _ visitor _ ri & # 39;, 'shard _ count & # 39, '50'); 同时借助ho logic RES的表格属性设置,根据业务场景进行针对性优化,主要包括以下几点:
(1)基本属性的设置
distribution_key
指定分布列表,数据将根据指定的列被洗牌到每个碎片。
set _ table _ property(& # 39;public . dwd _ intl _ TRD _ pay _ ITM _ buyer _ ri & # 39;, 'distribution _ key & # 39, '统计日期、统计时间、品牌标识、卖家标识& # 39;);clustering_key
将一些列指定为聚集索引。
set _ table _ property(& # 39;public . dwd _ intl _ TRD _ pay _ ITM _ buyer _ ri ',& # 39;' clustering_key ',& # 39;统计日期,统计小时,分类标识& # 39;);segment _ key
文件索引(File index),根据数据划分文件,可以通过segement _ key快速索引到一个文件。
set _ table _ property(& # 39;public . dwd _ intl _ TRD _ pay _ ITM _ buyer _ ri & # 39;, 'segment _ key & # 39, '统计日期,统计小时,业务部门标识,业务部门标识级别1,业务部门标识级别2,分类标识& # 39;);(2)高级属性的设置
设置合理的表组
表的关键作用是做局部连接,大大提高了连接的效率,尤其是在多表、大数据量的连接时。
调用set _ table _ property(& # 39;public . dwd _ intl _ TRD _ pay _ ITM _ buyer _ ri & # 39;, '与& # 39;, 'public . dwd _ intl _ log _ ipv _ ITM _ visitor _ ri & # 39;); Set Shard_count
数据量:7亿/230GB数据量,设定在2Kcore左右,事务30,流量50
示例资源:一个shard至少需要一个核负责计算
写性能:根据事务和流量的RPS指定
Join需求:当有查询案例中标Join时,考虑TableGroup。
SQL 调用set _ table _ property(& # 39;public . dwd _ intl _ TRD _ pay _ ITM _ buyer _ ri & # 39;, 'shard _ count & # 39, '30'); 调用set _ table _ property(& # 39;public . dwd _ intl _ log _ ipv _ ITM _ visitor _ ri & # 39;, 'shard _ count & # 39, '30');通过一系列优化,在实际业务场景中达到的优化效果如下:
1)用户从90年代增加了五端通讯模块-> 8s
2)淘宝直播模块查询从9s-> 2s
3)当前实时查询为1.8s
2。食人魔和实时闪现的融合
目前流计算任务的开发是基于使用BlinkSql的dataphin平台。这个平台使得实时任务的开发相当容易。在这里,我们主要记录一下ho roles作为实时任务的sink时需要注意的几点:
1)创建1)水槽表
2)分区路由设置
3)数据写入策略
3。数据的可视化
ho roles兼容PostgreSQL生态,提供JDBC/ODBC驱动,可以直接与BI工具接口,实现可视化展示。在实际业务中,主要使用数据服务(阿里叫oneservice)和FBI(阿里集团的可视化报表工具)。
1)数据服务
在数据中间平台的数据构造和数据服务的环节上,我们往往需要通过oneservice为我们开发的持久化数据提供统一的数据服务,就像生产者和消费者的模式一样。原方案设计是按照以下环节进行的[1]
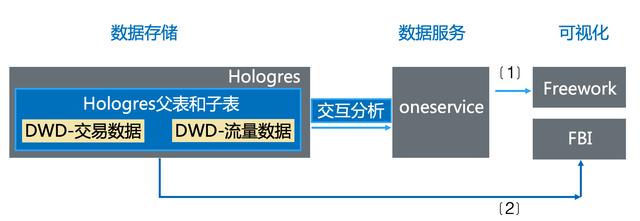
但在实际操作中,由于oneservice对交互分析场景的支持较弱,尤其是查询逻辑涉及实时连接时,会出现超时等问题。其次,当oneservice将查询查询下推到Hologres的查询时,oneservice的很多pg生态文法都不支持。最后,通过上图所示的链接[2],即通过FBI内置的Postgresql引擎,我们可以直接与Hologres连接,实现数据查询服务。
2)FBI可视化
数据集动态配置
在FBI层面,通过创建一个数据集,对商品、卖家、品牌三个页面进行统一分析,通过一个数据集动态实现查询服务。这里,需要数据集中应用的占位符和基于vilocity语法的动态配置。
python from dwd _ intl _ TRD _ pay _ ITM _ buyer _ ri 其中 stat _ date = & # 39;$ { bizdate:2020 07 22 } & # 39; #if((!${bu_level_two})和($ { bu _ level _ one } = = & # 34111")) 和bu _ id = & # 39$ { bu _ level _ one } & # 39 #elseif((!${bu_level_two})和(${bu_level_one}!= "111")) 和bu _ id _ level2 = & # 39$ { bu _ level _ two } & # 39 #elseif (( ${bu_level_two})和($ { bu _ level _ one } = = & # 34111")) 和bu _ id = & # 39$ { bu _ level _ one } & # 39 # else if($ { bu _ level _ two })和(${bu_level_one}!= "111")) 和bu _ id _ level1 = & # 39$ { bu _ level _ one } & # 39 # else and bu _ id _ level 1 = & # 39;$ { bu _ level _ one } & # 39 # end group by & # 39;$ { dims } & # 39页面布局设计
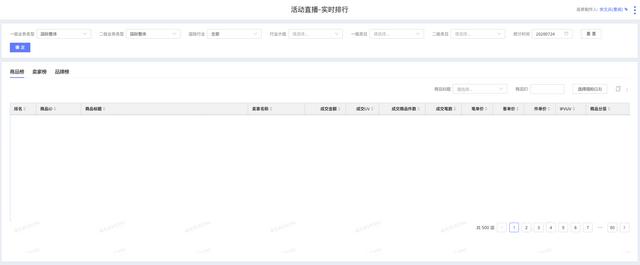
FBI的页面布局设计比较简单,可以直接通过报表模式展示,但是需要和营销活动分析的级联模式保持一致,尤其是一些涉及到行级关联的地方,还是需要一些技巧和设置的,否则初始化性能不是很好。最终页面和查询如下:
综上所述,使用ho roles后,除了上述统一计算、存储和服务的优势外,在业务方面还有几个突出的价值:
1。提高数据分析效率
公共层的详细数据存储在ho roles中,可以提供给业务端进行随机交互分析。与之前的立方体模型需要关联多个模型的检索方式相比,数据分析的效率大大提高。
2。保存数据刷新资源
整个公共层的明细数据只包含行业维度的叶子类别数据。在每年的行业类别调整中,不会因为类别维度表的变化而刷新数据,大大节省了用于刷新的数据资源。
八.未来规划1。保存存储空
因为需要看历史数据,所以需要保存最近400天的数据。明细数据过于庞大,需要对历史数据进行汇总。有成交的商品是27W x 400 = 1亿+(大促会更大)以减轻仓储压力。同时,我们还将与ho roles技术团队一起推出高压缩比的存储格式。
2。继续优化当前技术
目前通过Hollogres的交互分析技术和FBI的可视化工具,查询都可以围绕3s进行,但还有很多细节可以定制,比如查询优化、FBI的可视化工具的建立以及使用中的一些小问题,需要Hollogres的技术团队和FBI的技术团队共同打造,反馈技术链的构建会更加完善。
3。数据刷新方案
目前的技术方案不存在行业频繁调整导致的大量历史数据刷新的问题,但是如果有一些逻辑调整或者一些不可控因素需要刷新历史数据,就需要设计一个实时的数据刷新方案。
4。重用到更具交互性的分析场景
由于目前ho logic RES中存储了大量的交易和流量的IPV详细数据,因此有很多数据广告牌和数据分析可以直接重用当前数据,直接对数据集进行自由交互分析,从而提高数据研发、数据分析、产品打造等的研发效率。
作者:文婧阿里巴巴数据技术与产品部数据技术专家
本文为阿里云原创内容,未经允许不得转载。







