
抢货单有两种:抢手货抢单和非抢手货抢单,所以本系统的抢单模式不是一种。
3.1 抢单分析
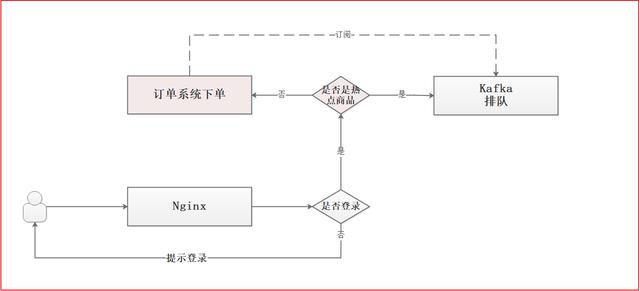
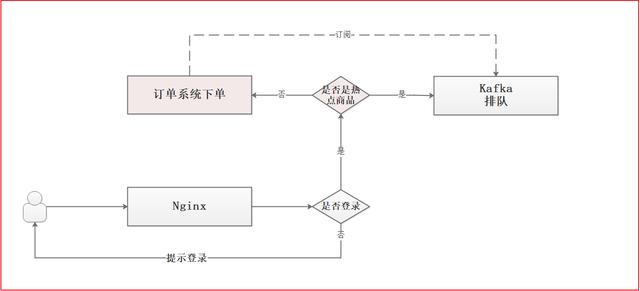
如上图所示,用户登录后,通过nginx抢单。这时,用户首先会判断商品是否为热销商品。如果不是热销商品,他们会直接调用订单系统下单。如果是热门商品,会排队到kafka生产消息下单,订单系统会订阅排队订单信息,可以减少服务器直接承担的抢单压力。此操作也称为队列剪辑。
3.2 非热点商品抢单我们可以在订单系统中抢非热销商品的订单,也只能在订单系统中抢非热销商品的订单,但抢单时要注意以下问题:
1.先减少库存 2。库存减少成功后,下单 3。下单失败,需要实现分布式交易 4。下单成功后,记录用户抢单信息,24小时内不允许再次抢货 5。在抢单中,可能被抢购的商品只是成为
/* * *减少库存 * @ param ID * @ param count * @ return */ @ update(& # 34;UPDATE TB _ SKU SET sec kill _ num = sec kill _ num-# { count }其中id=#{id}和islock=1和seckill _ num & gt= # { count } & # 34) int dcount(@ Param(& # 34;id & # 34)字符串id,@ Param(& # 34;伯爵& # 34;)整数计数); 这里我们需要控制数据的原子性,所以不能在内存中操作。我们需要使用SQL语句在数据库中执行。
1)库存下降
修改sec kill-goods ' com . sec kill . goods . service . SKU服务,增加减少库存的方法,代码如下:
/* * *库存下降 * @ param ID * @ param count * @ return */ int count(string ID,integer count); 修改seckill-goods的com . sec kill . goods . service . impl . skuseriseimpl中增加存货减量的实现方法,代码如下:
/*** *库存下降 * @ param ID * @ param count * @ return */ @ override public int count(string ID,inte if(dcount & lt;=0){ //拒绝失败,查询状态 SKU SKU = skumapper。selectbyprimarykey(ID); if(SKU . getis lock()= = 2){ return 205; } if(SKU . getseckillnum()& lt;count){ return 405; } } return dcount; } 修改com . sec kill . goods . controller . SKU controller增加减少库存的调用方法,代码如下:
/* * * * SKU数量在减少 * @ return */ @ put mapping(value = & # 34;/dcount/{ id }/{ count } & # 34;) 公共结果& ltSku & gtdcount(@ path variable(value = & # 34;id & # 34)字符串id,@ path variable(value = & # 34;伯爵& # 34;)整数count){ int code = SKU service . dcount(id,count); String message = & # 34;"; Sku Sku = null; 开关(代码){ 情况1: 消息= & # 34;库存减少成功& # 34;; SKU = SKU service . find byid(id); break; 案例405: message = & # 34;库存不足& # 34;; break; 案例205: message = & # 34;这种商品是抢手货& # 34;; break; 默认值: } 返回新结果& ltSku & gt(真,代码,消息,SKU); } 2)SKU fein配置
修改com . sec kill . goods . feign . SKU feign,添加库存下降方法,代码如下:
/* * * * SKU数量在减少 * @ return */ @ put mapping(value = & # 34;/SKU/dcount/{ id }/{ count } & # 34;) 结果& ltSku & gtdcount(@ path variable(value = & # 34;id & # 34)字符串id,@ path variable(value = & # 34;伯爵& # 34;)整数计数); 3.2.2抢单的实现当库存下降成功时,需要直接为用户下单。如果下降不成功,商品就会成为热销商品。我们需要向Kafka发送队列数据,因此需要介绍Kafka配置。
Bootstrap.yml配置kafka:
Kafka: 生产者: ack:all # ack:消息确认机制,默认值为0,acks = 0:如果设置为0,生产者不会等待Kafka的响应。Acks = 1:该配置意味着kafka会将该消息写入本地日志文件,但不会等待集群中其他机器的成功响应。Acks = all:这种配置意味着领导者将等待所有追随者完成同步。确保此消息不会丢失,除非kafka集群中的所有机器都挂起。这是最强的可用性保证。 重试次数:发送失败重试0次。如果配置为大于0的值,客户端将在发送失败时重新发送消息。 batch-size: 16384 #当多个消息需要发送到同一个分区时,生成器会尝试合并网络请求。这将提高客户和生产商的效率。 buffer-memory: 33554432 #是一个32MB的批处理缓冲区 key-serializer:org.apache.kafka.com mon . serialize . string serializer Value-serializer:org.apache.kafka.com mon . serialize . string serializer bootstrap-servers:kafka-server:9092 #如果Kafka启动不正确,打开调试级日志并可以& # 39;t解析地址:flink:9092错误,需要修改windows下的IP映射,C: Windows系统32驱动程序etc主机,192.168.234.128 Flink。 消费: group-ID:test auto-offset-reset:latest #(1)早:当每个分区下都有提交的偏移量时,从提交的偏移量开始消费;没有提交抵销时,从零开始消耗;(2)最新:每个分区下有提交的抵销时,从提交的抵销开始消耗;当没有提交的偏移时,将消耗该分区下新生成的数据;(3)无:当主题的每个分区都有提交的偏移量时,在偏移量之后开始消费;只要一个分区中没有提交的偏移量,异常 enable-auto-commit: true #如果为true,将在后台定期提交消费者的偏移量。 auto-commit-interval:1000 #消费者偏移量自动提交给Kafka的频率(以毫秒为单位),默认值为5000 max-poll-records: 5 #一次拉起的片段数 key-desiralizer:org.apache.kafka.com mon . serialization . string desiralizer Value-Deserializer:org.apache.kafka.com mon . serialization . string Deserializer bootstrap-servers:Kafka-server:9092 修改
/** *增加顺序 * @ param order */ @ override public int add(order order){ /1。库存减少 结果& Sku & gtresult = SKU fein . dcount(order . getid(),1); /2。递减成功,order if(结果。get code()= = 1){ /商品秒杀价 Sku Sku = result . get data(); order . setname(SKU . getname()); order . set price(SKU . getseckillprice()); order . setid(& # 34;不& # 34;+id worker . nextid()); order . setorderstatus(& # 34;0"); order . setpaystatus(& # 34;0"); order . setcommissionstatus(& # 34;0"); order mapper . insert selective(order); } else if(结果。getcode () = = 205) {//3。货转热货,排队[/h //检查用户是否在排队 String key = & # 34;SKU _ & # 34;+order . gets kuid(); String user key = & # 34;用户& # 34;+order . get username()+& # 34;ID & # 34+order . gets kuid(); //如果为true,则表示用户正在排队 Boolean Bo = redistemplate。boundhaops(键)。Haskey(用户密钥); 如果(!bo){ Map & lt;String,String & gtorderMap = new HashMap & ltString,String & gt(); order map . put(& # 34;用户名& # 34;,order . get username()); order map . put(& # 34;id & # 34,order . getskuid()); //排队抢单 Kafka template . send(& # 34;新秩序& # 34;,JSON . tojsonstring(order map)); } return 202; } return result . get code(); } 使用以下代码修改com . sec kill . order . controller . order controller的add方法:
/*** *添加订单数据 * @ return */ @ get mapping(value = & # 34;/{ id } & # 34;) 公共结果add(@ request header(value = & # 34;授权& # 34;)字符串授权,//token @ path variable(value = & # 34;id & # 34)字符串id) //商品ID { //解析令牌 映射
ngx . header . content _ type = & # 34;应用/JSON;charset = utf8 & # 34 -介绍json库 local cjs on = require & # 34;cjson & # 34 -引入jwt模块 local jwttoken = require & # 34;token & # 34 -获取请求头中的令牌数据 local auth _ header = ngx . var . http _ authorization -调用令牌检查 local result = jw token . check(auth _ header) -如果code==200表示令牌验证通过 ifresult。code = = 200 then -get ID local uri _ args = ngx . req . get _ uri _ args() local ID = uri _ args。id & # 34] -拼接url 本地url = & # 34/API/order/& # 34;。id -执行请求 ngx . exec(URL) else -输出结果 ngx . say(cjs on . encode(result)) ngx . exit
#抢单 位置/Lua/order/add { content _ by _ Lua _ file/usr/local/openresty/nginx/Lua/sec kill-order-add。Lua } #微服务网关 位置/API/{ proxy _ pass http://192 . 168 . 1 . 5:8001; } 注意,在POST提交的情况下,Lua脚本需要读取请求体数据:
1 2 3 ngx . req . read _ body() ngx . req . get _ post _ args() 热货和非热货不一样。热门商品已被隔离。在Redis缓存中,而且抢到的热门商品订单必须是高效运行且能承受压力的,Nginx的并发量远远超过tomcat,所以我们可以使用Lua+Nginx进行抢到的热门商品订单。
3.3.1 抢单流程分析
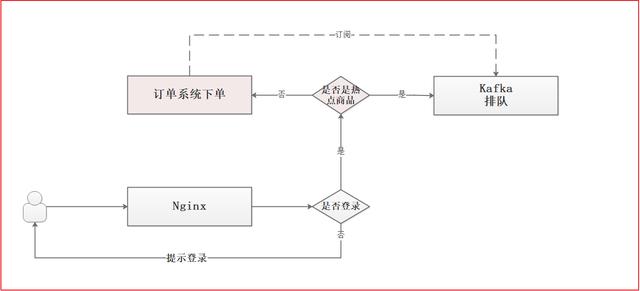
用户进入抢单流程,通过Lua脚本判断令牌是否有效。如果有效,用户进入抢单流程,我们对抢单流程的执行过程进行分析:
1。确定该商品的用户是否在24小时内购买了 。2.如果有,直接提醒用户24小时内不能购买 。3.如果用户没有购买该商品,确定是否为热销商品 4。如果是非热门商品,走非热门商品抢单流程[/h]然后走热门商品抢单流程 6。判断商品用户是否排队,如果没有,进入队列,如果是,提示用户排队 7。将订购流程交给订购系统,订购系统通过队列订阅读取用户的订购信息。并下单
3.3.2 Lua实现Redis操作判断用户是否在24小时内抢购商品,我们可以将用户抢购订单的信息存储到Redis缓存中,24小时固定时间过期。这时候我们需要在Lua中实现Redis集群操作,需要lua-resty-redis-cluster的支持。
我们需要安装lua-resty-Redis-cluster,下载地址是https://github.com/cuiweixie/lua-resty-redis-cluster.下载文件配置后,就可以实现Redis集群操作了。
3.3.2.1 配置lua-resty-redis-cluster1)Lua-resty-redis-cluster配置将下载的文件上传到服务器的`/usr/local/openresty目录下,解压。我们只需要使用包中的两个文件rediscluster.lua和redis_slot.c。
将Lua-resty-redis-cluster/lib/redis _ slot . c复制到openresty/lualib目录,将Lua-resty-redis-cluster/lib/resty/redis cluster . Lua复制到openresty/lualib/resty目录。
复制redis_slot.c:
CD/usr/local/openresty/Lua-resty-redis-cluster-master/lib/ cpredis _ slot . c/usr/local/openresty/Lua lib/ copy redis disc。
CD/usr/local/openresty/Lua-resty-redis-cluster-master/lib/resty cprediscluster。Lua/usr/local/open resty/Lua lib/resty/
CD/usr/local/openresty/Lua lib gcc redis _ slot . c-fpic-shared-o libre dis _ slot . so 编译时可能会出现以下错误

错误解决方案:
解决方法:应该是lua版本不对,内置lua不好用 方法一:删除内置lua,一般是/usr/lua和/usr/luac,删除这两个文件 方法二:yum安装lua-devel下载一个依赖项 方法三
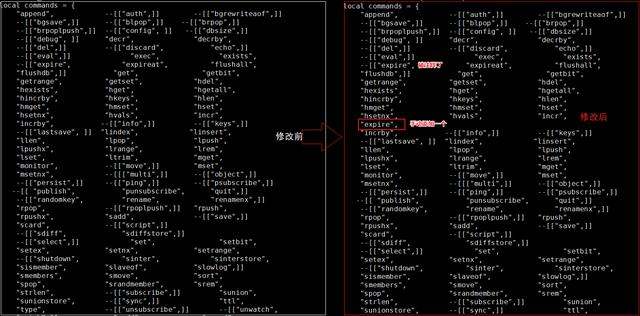
2)指令配置在lua-resty-redis-cluster中,有些redis指令是不开放的。我们可以手动修改和打开相关指令。我们在这里打开过期的指令,因为这个指令以后会用到。
修改/usr/local/open resty/Lua lib/resty/redis cluster . Lua文件,添加相关说明,如下图所示:
Redis将来也可能用在其他地方。我们可以写一个工具类redis-cluster.lua来实现redis的操作。这里主要实现按键获取缓存数据、按键设置缓存过期时间、按键从hash类型获取数据、向hash类型添加数据等功能。代码如下:
- redis连接配置 local config = { name = & # 34;测试& # 34;, serv _ list = { { IP = & # 34;192.168.211.137",port = 7001}, { IP = & # 34;192.168.211.137",port = 7002}, { IP = & # 34;192.168.211.137",port = 7003}, { IP = & # 34;192.168.211.137",port = 7004}, { IP = & # 34;192.168.211.137",port = 7005}, { IP = & # 34;192.168.211.137"、port = 7006}、 }、 idle _ timeout = 1000、 pool _ size = 10000、 } -介绍redis集群配置[resty . redis cluster & # 34; -定义一个对象 Local lre dis = { } -query function lre dis . Get(key) -创建一个链接[/h]Red:init _ pipeline() -根据key获取数据 Red:Get(key) Local error = Red:commit _ pipeline() -关闭链接。return result end -使用到期 函数lredis添加数据。setexp (key,value,Time) -创建链接 local red = redis _ cluster:new(config) red:init _ pipeline() -添加密钥并设置过期时间 red:。Value) red: expire (key,time) local error = red:commit _ pipeline() end -根据key查询hash 函数。2) -创建链接 local red = redis _ cluster:new(config) red:init _ pipeline() -根据键获取数据 red:hm Get(2) local error = red:commit _ pipeline() -关闭链接 red: close () 返回错误[1] Value) -创建链接 local red = redis _ cluster:new(config) red:init _ pipeline() -添加哈希数据 red:hm set(key)Value) local error = red:commit _ pipeline() -关闭链接 red: close () 返回错误 end [/h函数 Value) -创建链接 local red = redis _ cluster:new(config) red:init _ pipeline() -添加哈希数据 red:hincrby(hincrby)Value) local error = red:commit _ pipeline() -关闭链接 red: close () 返回错误 end
# redis location/test/redis { content _ by _ Lua & # 39; ngx . header . content _ type = & # 34;应用/JSON;charset = utf8 & # 34[/h -介绍redis local r redis = require & # 34;redis-cluster & # 34;[/h -从redis local SKU = rre dis . hget(& # 34;SKU _ s 1235433012716498944 & # 34;,"num & # 34)[1] ngx . say(SKU) & # 39;; } 测试结果如下:

用户抢单的时候,如果是热销商品,这个时候就要让用户排队。当用户排队时,我们需要将抢单信息发送给kafka,所以需要使用Lua脚本来操作kafka,并且需要依赖lua-restry-kafka库,我们已经配置使用过了,这里就不需要配置了。
将来可能会有很多地方用到kafka,所以我们也可以单独为kafka提取一个配置脚本,创建一个名为' kafka.lua '的脚本,用来配置kafka的操作。代码如下:
-创建对象 local Kafka = { } -Kafka依赖库 local client = require & # 34;resty . Kafka . client & # 34; local producer = require & # 34;resty.kafka .制片人& # 34; -配置kafka的链接地址 Local broker _ list = { { host = & # 34;192.168.211.137",port = 9092 } } -发送消息 -队列名:队列名[/h -内容:已发送内容 函数kafka.send (Queuename,content)async & # 34;}) -发送消息 local offset,err = pro: send(队列名,nil,内容) -返回结果 返回offset end 返回kafka。
# Kafka 位置/测试/Kafka { content _ by _ Lua & # 39; ngx . header . content _ type = & # 34;应用/JSON;charset = utf8 & # 34[/h -介绍卡夫卡 本地卡夫卡= require & # 34卡夫卡& # 34;[/h -发送消息 localoffset = Kafka。发送(& # 34;演示& # 34;,"你好& # 34;) ngx . say(offset) & # 39;; } 测试结果如下:

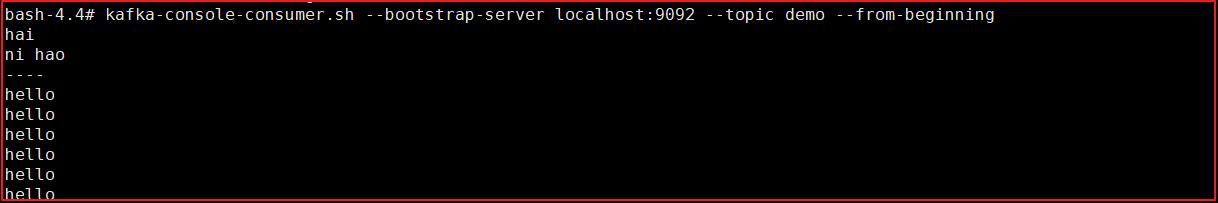
这里,订单分为两部分。首先,我们需要将抢单信息发送给Kafka进行排队。排队后订单系统订阅抢单信息下单,所有数据操作都在Redis完成,减轻了程序对服务器的压力。
3.3.4.1 排队排队抢单需要引入redis和kafka,我们的实现思路如下:
1.检查用户令牌,如果没有通过直接结束程序,提示用户 2。通过令牌检查,从Redis获取用户在24小时内抢购产品,如果抢购了直端程序,提示用户 3。如果符合购买该产品的条件,查看该产品是否为热销产品,如果不是,直接请求后台下单 4。0,检查用户是否已经在队列中,使用redis的incr增量确定队列数,消除重复队列 5。如果没有队列,发送消息给Kafka实现排队 创建seckill-order-add.lua,实现代码如下:
ngx . header . content _ type = & # 34;应用/JSON;charset = utf8 & # 34 -介绍json库 local cjs on = require & # 34;cjson & # 34 -引入jwt模块 local jwttoken = require & # 34;token & # 34 -介绍redis local redis = require & # 34;redis-cluster & # 34; -介绍卡夫卡 本地卡夫卡= require & # 34卡夫卡& # 34; -获取请求头中的令牌数据 local auth _ header = ngx . var . http _ authorization -调用令牌检查 local result = jw token . check(auth _ header) -如果code==200表示令牌验证通过 ifresult。code = = 200 then -响应结果 local response = { } -获取ID localuri _ args。id & # 34] -确定该产品的用户是否在指定时间内购买了该产品 local username = result[& # 34;正文& # 34;]["有效载荷& # 34;]["用户名& # 34;] 本地用户密钥= & # 34;用户& # 34;..用户名.."ID & # 34。id local hasbuy = redis。get(用户密钥) -不买的话,has buy = = nilor has buy[1]= nilor has buy[1]= SKU _ & # 34;..id,& # 34;num & # 34)[1] -如果不是抢手货就走普通抢单流程 如果num = = nil或者num = = ngx . nullthen -拼接url 本地url = & # 34/API/order/& # 34;。id -执行请求 NGX。exec(URL) return else -热门商品 num = to number(num) [/h = 0 then -库存不足,无法排队 响应[& # 34;代码& # 34;]=405 响应[& # 34;消息& # 34;]="目前,商品库存不足以抢购& # 34; ngx . say(cjs on . encode(response)) return else -递增队列 local incr result = redis . hincrby(& # 34;SKU _ & # 34;。id,userkey,1) incr result = to number(incr result) if incr result = = 1然后 -热数据,发送MQ队列 本地用户顺序= {} 用户名& # 34;]= username user order[& # 34;id & # 34]= ID -排队抢单 Kafka . send(& # 34;新秩序& # 34;,cjs on . encode(user order)) response[& # 34;代码& # 34;]=202 响应[& # 34;消息& # 34;]="你在排队等着抢购这种产品& # 34; ngx。说(cjson。encode(response)) return else -response用户正在排队购买产品 response[& # 34;代码& # 34;]=202 响应[& # 34;消息& # 34;]="你在排队等着抢购这种产品& # 34; NGX。说(cjson。encode(response)) return end end else -24小时内购买此商品 code & # 34;]=415 响应[& # 34;消息& # 34;]="您已经在24小时内抢购了该产品。你不能再抢购了& # 34; ngx . say(cjs on . encode(response)) return End else -output result ngx . say(cjs on . encode(result))[End
3 . 3 . 4 . 2下单的实现[/S2/]创建com . sec kill . order . config . kafkaorderlistener,用于读取排队信息和调用下单。代码如下:@ Component public class KafkaOrderListener { @ Autowired private OrderService OrderService; /* * *听消息 *创建订单 * @ param消息 */ @ Kafka listener(topics = { & # 34;新秩序& # 34;}) public void receive(string message){ //将消息转换为map map
/* * *热点数据顺序 * @ param order map */ void addhotorder(map
/*** * 秒杀下单 * @param orderMap */ @Override public void addHotOrder(Map<String, String> orderMap) { String id = orderMap.get("id"); String username = orderMap.get("username"); //key String key = "SKU_" + id; //用户购买的key String userKey = "USER" + username + "ID" + id; if (redisTemplate.hasKey(key)) { //数量 Integer num = Integer.parseInt(redisTemplate.boundHashOps(key).get("num").toString()); //拥有库存,执行递减操作 if (num > 0) { //查询商品 Result<Sku> result = skuFeign.findById(id); Sku sku = result.getData(); Order order = new Order(); order.setCreateTime(new Date()); order.setUpdateTime(order.getCreateTime()); order.setUsername(username); order.setSkuId(id); order.setName(sku.getName()); order.setPrice(sku.getSeckillPrice()); order.setId("No" + idWorker.nextId()); order.setOrderStatus("0"); order.setPayStatus("0"); order.setConsignStatus("0"); orderMapper.insertSelective(order); //库存递减 num--; if (num == 0) { //同步数据到数据库,秒杀数量归零 skuFeign.zero(id); } //更新数据 Map<String, Object> dataMap = new HashMap<String, Object>(); dataMap.put("num", num); dataMap.put(userKey, 0); //存数据 redisTemplate.boundHashOps(key).putAll(dataMap); } //记录该商品用户24小时内无法再次购买,测试环境,我们只配置成1分钟 redisTemplate.boundValueOps(userKey).set(""); redisTemplate.expire(userKey, 1, TimeUnit.MINUTES); } }







