
林伟,阿里云智能研究员,阿里云智能通用计算平台MaxCompute,机器学习PAI平台技术负责人
本文将从三个部分向读者讲述线下实时集成数据仓库的不断演进,以及湖库-云原生大数据平台的集成。通过从数据湖到数据仓库的历史,反思为什么要做湖库融合,为什么湖库融合在现阶段开始做线下和实时的数据仓库融合。
希望这个分享能帮助我们进一步理解为什么要做湖仓一体化。
一、湖仓一体(1)阿里巴巴从数据湖到数据仓库的历程
2007年,宁波战略大会决定建立一个发展的、协同的、繁荣的电子商务生态系统,其中数据是生态系统的核心。但此时各业务部门都在垂直发展数据能力,用数据支撑业务决策服务。这些数据中心支撑着业务部门的发展。当我们到达一个发展阶段时,我们希望进一步挖掘各个业务部门的数据之间的相关性,从而利用这些高层次的数据分析来挖掘更高的商业价值。我们遇到很多困难,因为数据来自不同的部门,不同的人会给你提供不同的数据集,没有清晰的数据质量监控,你也不知道这些数据是否完整,所以你需要花费大量的时间不断地校准数据。这个过程耗时太长,而且在大多数情况下,会做很多无用功,实际上降低了公司整体的效率。
所以在2012年,我们决定把所有业务部门的数据都连接起来,决心做到“一个数据,一个服务”。这个过程其实就是一个数据湖升级到几个仓库的典型过程,但是难度很大,因为我们缺乏一个湖库一体化的好的系统沉淀。我们称这个过程为“登月”。从这个名字就能看出中间的难度。在此期间,每个团队甚至需要停止日常业务开发以配合数据整理,并将现有的所有数据分析流程迁移到统一的仓库盘点系统中。最终,经过18个月,我们在2015年12月以极高的成本完成了统一大数据仓库平台的搭建,这就是阿里巴巴的MaxCompute。通过这个统一的仓库平台,业务团队、服务商、物流或其他环节都可以方便、快捷、更好地发掘商机。所以我们可以看到,阿里巴巴统一大数据平台建成后,业务增长也进入了快车道。正是因为有了更好的数据支持,商家和客户才能快速做出一些商业决策。
(2)数据仓库和数据湖的关系
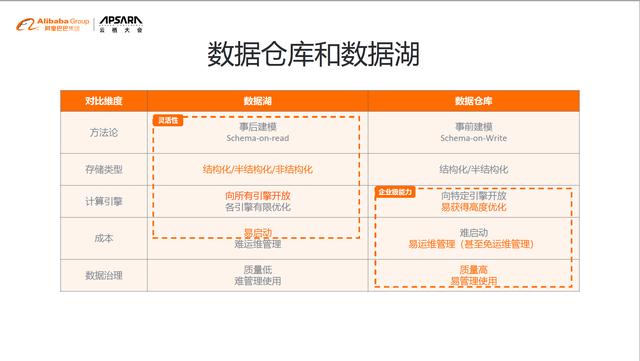
从开发者的角度来看,数据湖更灵活,更喜欢这种任意模式。任何引擎都可以不受约束的读写,启动起来非常容易。
从数据管理者的角度来看,数据湖可以作为一个起点,但当它达到一定规模时,当数据被视为资产或需要更大的业务决策时,就需要有一个好的数据仓库。
(3)数据仓库和数据湖系统的增长曲线
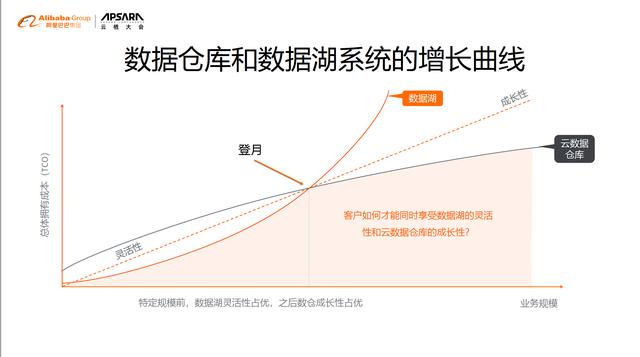
上面展示的成长曲线,基本上就是阿里发展的曲线。刚开始也是数据湖的状态。各业务单元独立发展,起步快,灵活性强。但是到了一定规模,数据就难以管理了,各个业务部门的数据逻辑语言不一致,很难对齐。所以当时50%、80%的无效时间都花在了查资料上。随着规模的不断扩大,这种损失越来越大,迫使我们不得不推进公司统一数据仓库的建立。
(4)湖与仓库的融合
正是因为我们经历了堪比“登月”的痛苦,所以我们不希望MaxCompute的未来企业客户经历这样痛苦的过程,所以我们搭建了一个湖库一体的开发平台。当公司规模较小时,您可以使用数据湖能力更快地定制自己的分析。当公司成长到一定阶段,需要更好的数据管理和治理手段时,湖库一体化平台可以对数据和数据分析进行无缝升级和有效管理,使公司在数据管理上更加规范。这是湖库一体化设计背后的核心思想。
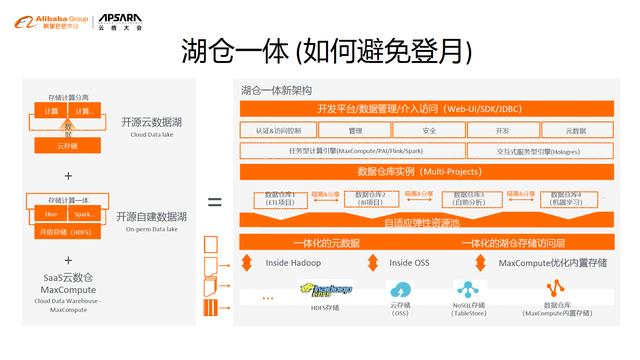
我们把湖泊系统和仓库系统有机地结合起来。起初,没有元数据。当你想建几个仓库的时候,我们可以从湖里提取这些元数据。这些元数据与仓库元数据一起放在一个集成的元数据分析平台上。许多数据仓库的数据管理平台都可以建立在这些元数据之上。
同时,在数据仓库的平台上,我们有效地支持了许多分析引擎,包括基于任务的计算引擎,如MaxCompute的批处理、Flink的流处理、机器学习等。,以及可以分析我们数据的开源组件。还有一个面向服务的数据引擎,可以支持交互查询服务,实时显示我们的数据,用户可以在这个服务引擎上构建自己的数据服务应用。
在该引擎之上,我们构建了丰富的数据管理工具,使业务部门能够进行高效和全面的数据治理。这都是因为我们打通了湖库的数据,这也是整个湖库一体化设计的核心。
二、离线在线数仓一体化现在社会越来越方便,客户需要更快的做出商业决策。在双十一GMV实时大屏、春晚实时大屏直播以及机器学习从线下模型到线上模型的趋势的数据分析中我们都可以看到。这些需求推动了实时数据仓库的发展。
实际上,实时数据仓库和离线数据仓库有相似的开发过程。当时在实时系统发展的初期,我们首先考虑的是引擎,因为你只有先有引擎才能分析实时数据,所以阿里巴巴重点研发了Flink这样的流媒体计算引擎。但是只有在流计算引擎阶段,类似于数据湖,我们缺乏对分析结果数据的管理,所以在第二阶段,我们使用我们的线下仓库产品来管理这些分析结果,使分析结果可以在我们整体的数据仓库和数据管理中进行管理。但是将实时分析后的结果放在离线仓库中,对于实时业务决策来说显然不够及时。所以我们现在正在开发第三阶段:实时仓库盘点。
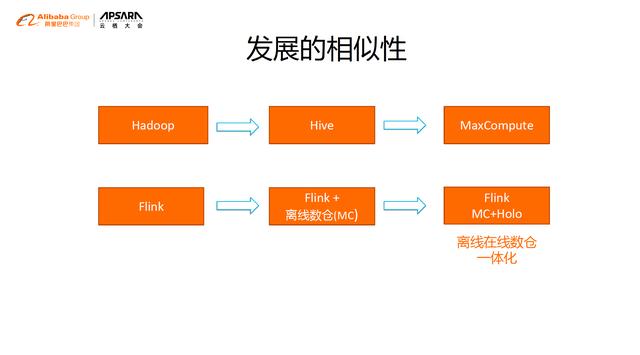
我们会将流媒体引擎的分析结果实时写入实时数据仓库ho roles,以便BI对分析结果进行实时分析,从而有效支持客户的实时业务决策。
这是离线和在线数据仓库集成的设计。
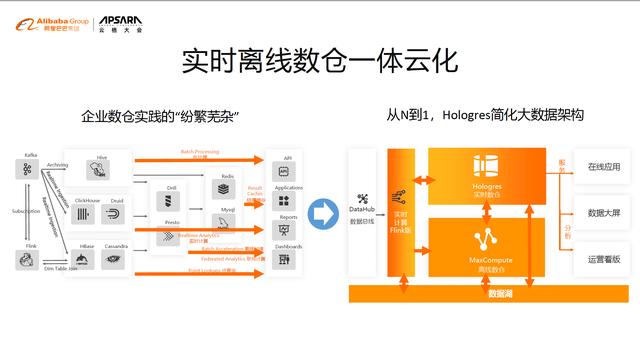
综上所述,在离线和在线数据仓库整合之前,原始分析是一个复杂的过程。有线下,线上和很多不同的引擎。现在总结一下,或者简化成上面所示的结构。我们将使用实时引擎进行预处理。经过预处理后,我们会将这些数据写入MaxCompute的离线数据仓库,或者同时写入ho roles的实时数据仓库,这样我们就可以做更实时的面向服务的BI分析。而MaxCompute的离线数据仓库存储成本更低,吞吐性能更好,可以做大量的离线数据分析,这就是离线数据仓库集成的设计。
通过集成设计,您可以为客户带来非常平衡的系统。根据数据场景或业务场景,您可以使用批处理。通过数据压缩和冷存储,将数据按照冷热方式分梯度存储,可以获得更低成本的离线分析。
当我们更加关注数据的实时价值时,就可以用流量计算引擎来做。同时希望快速互动,希望通过各种方式、维度、角度快速观察生成的报告。这时候就可以利用交互引擎,对数据进行高度提纯后,洞察到各个维度。
希望能和湖库一体化平台达到一个很好的平衡,根据实际业务量、要求、规模成本达到一个更好的点。
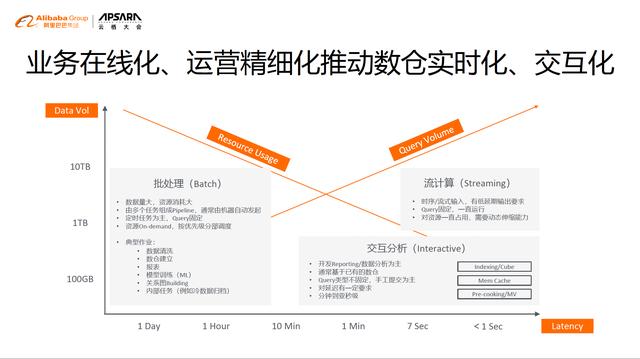
总的来说是希望在湖库一体化体系上,无论是线下还是线上。不同的分析引擎可以支持各种分析,在线服务引擎可以用于实时BI,可以实现低成本、定制能力以及实时和在线服务之间的各种平衡。使客户能够根据实际业务场景进行选择。
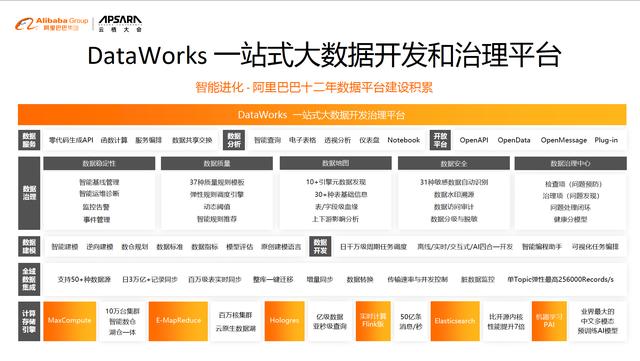
三、智能数仓有了统一的数据仓库平台,我们就可以在其上构建强大的数据治理或分析平台,这就是我们的DataWorks。这个平台上有很多数据建模工具,提供数据质量和标准、血缘关系分析、编程助手等等。正是因为湖库的线上线下一体化的基础能力,我们才有了让大数据开发治理平台更加智能化的可能。以便与我们的企业客户分享更成熟有效的数据治理经验。
原文链接:https://developer.aliyun.com/article/804337? UTM _ content = g _ 1000308694
本文为阿里云原创内容,未经允许不得转载。







