
导语腾讯Aegis开放通用推荐系统一般把推荐问题变成分类问题,而对于榜单推荐场景,推荐问题更类似于排名问题。本文将介绍排名学习技术与推荐算法相结合的成对方法及其具体实现——成对排名因式分解机(PRFM)算法,并分享PRFM算法在手q动画Feeds流推荐场景中的应用,供希望将该算法应用于其他场景的同学参考。
1。概述
目前aegis推荐中的算法一般将推荐问题形式化为二元分类问题:以动画推荐为例,如左图所示,对于用户和他所暴露的物品集合,点击视为正样本(label =1),没有点击视为负样本(label =0),可以用< Users,items >(用户,物品>)来构造:用标签组成的训练样本来训练二元分类模型。
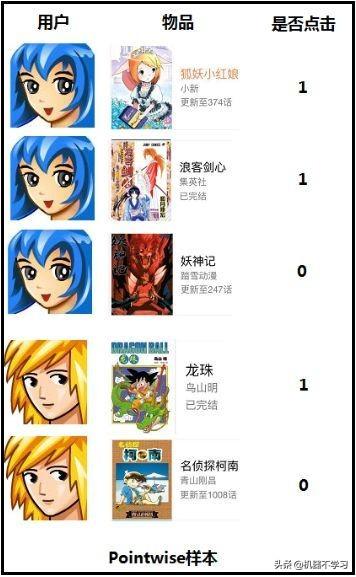
这种方法称为逐点法,即在参数训练阶段,模型只考虑每一个:独立评分,目标是使所有正样本得分高于负样本得分。如左图所示,逐点法的训练目标是将模型给:,& lt小蓝,浪客·辛建>:,& lt黄啸,龙珠>:分数都高于
仔细考虑之后,不难发现逐点法的不足之处。例如,对于黄啸,只需给出模型:得分是否高于:是,至于:得分是否高于
本文介绍的成对方法改进了成对方法的缺点,训练样本由:三元组构成,其中项1为该用户点击的项,项2为该用户未点击的项。Pairwise方法重点是判断对象对< item 1,item 2 >:是否满足序关系(即< User,Item 1 >:得分是否高于:).如下图所示,两两法在模型训练阶段的目标是: :得分高于:,& lt黄啸,龙珠>:分数高于:。
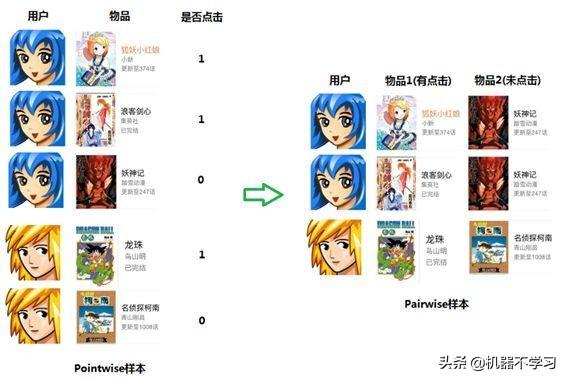
另一方面,在逐点法的样本构造中,我们简单地将点击视为正样本,未点击视为负样本,这相当于给逐点法增加了一个假设:用户点击的项目是用户明确喜欢的,未点击的项目是用户明确不喜欢的。实际上,点击行为是隐性反馈,这似乎太强了。成对方法的假设更现实:用户更喜欢他点击的项目,而不是他没有点击的项目。
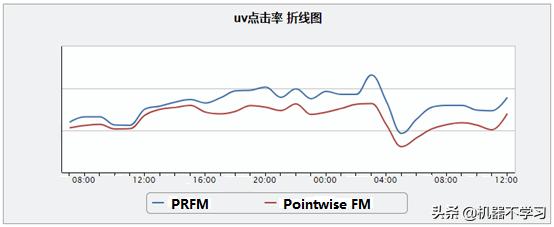
成对方法作为学习排序技术和推荐系统算法的结合,近年来受到学术界和工业界的密切关注和研究。本文介绍的成对排序因式分解机(PRFM)算法是成对方法的具体实现。我们实现了Feeds推荐中的PRFM算法,并应用到手Q动画首页的feedstream推荐场景中。与逐点FM算法相比,PRFM算法在相同的特征下,uv点击率相对提高了约5%。
2。PRFM算法的细节
与逐点法一样,成对法可以选择不同的模型进行:评分,如LR、FM等。因为FM模型可以节省LR模型在特征工程上的人力消耗,而且实践证明使用原始特征的FM经过人工调优后可以达到比LR更好的在线效果,所以我们选择FM模型作为评分公式。就样本构造而言,许多文章对< Item 1,item 2 >:从而获得:的样本实例。如果考虑所有样本,样本会太大而无法训练。因此,我们采取的策略是为每个用户随机选择100对商品。
上述样本构造和评分模型构成了成对排序因式分解机(PRFM)算法。这里有一些关于PRFM算法的数学细节。不感兴趣的同学可以跳过这一部分。
FM模型的评分公式为:(是由用户特征、物品特征、上下文特征等组成的特征向量。)
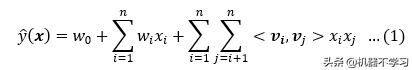
在…之中
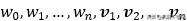
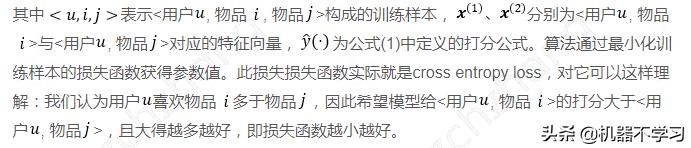
是要训练的参数。参数训练中使用的损失函数定义为:
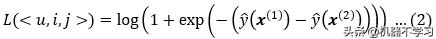
3。排序算法的离线评价指标及参数调整
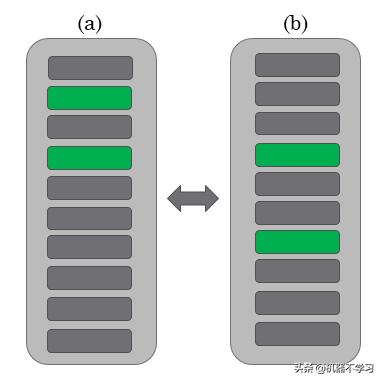
与使用AUC作为分类问题的评价指标不同,常用的衡量排名性能的评价指标主要有K处的Precision、Map (Mean Average Precision)和K处的NDCG(Normalized Discounted Cumulative Gain),下面我们通过一个例子简单介绍一下这些指标的定义和计算方法(在下图左图所示的曝光项目列表中,绿色代表用户点击的项目,灰色代表用户没有点击的项目)。
k处的精度:(Prec@k)
用户点击的条目在列表前k项中所占的比例,数值越高,推荐质量越高。如左侧示例所示,在列表(a)中,5处的精度= 2/5 = 0.4,在列表(b)中,1/5 = 0.2。可以为每个用户计算k处的精度,并且可以通过平均所有用户来获得用户集合的k处的精度。
MAP(平均精度):
可以看作是precision在k处的加强版,将用户在列表中点击的项目的位置加入到索引的计算中。数值越高,推荐质量越高。AP (average precision)是指在每个用户点击的项目的位置k处,求一次k处的精度,然后求平均值。比如list (A)中的AP=(1/2+2/4)/2=0.5,list (B)中的AP=(1/4+2/7)/2=0.268,可以看出,从精度在10的角度来看,list(A)和list(B)没有区别,同样,可以为每个用户计算一个AP,平均所有用户就可以得到用户集的映射。
k时的NDCG(归一化贴现累积收益):(NDCG@k)
k处NDCG的计算比较复杂,这里就不详细介绍了。感兴趣的同学可以自行搜索一下。简单来说,在NDCG的计算中,用户点击的物品在列表中出现的次数越多,就被认为越有价值,这和地图的思路是一致的。
知道了算法的离线评价指标后,就可以对其参数进行优化。和逐点FM算法一样,PRFM算法可以调整的参数有:正态分布的标准差(init_std)、正则化系数(reg)和模型参数初始化时使用的隐向量维数(factor)。下图显示了手Q动画馈送流的调节示例。根据调优结果,我们决定使用以下参数:init_std=0.005,reg=0.0001,factor=100。
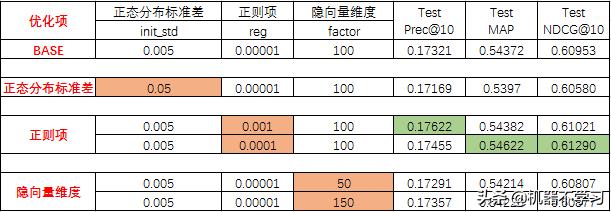
注:橙色方框表示调整后的参数,绿色方框表示各指标的最大值。
4。算法改进计划
如前所述,PRFM算法的样本构造方法是随机选取 100 <第1项,第2项>:但有研究表明,使用不同的采样策略可以提高模型效果(见参考文献1)。比如对于每个用户,物品对:按照物品1和物品2在曝光列表中的位置差异从大到小排序,取前100。这种采样策略的思想是,暴露列表中第1项和第2项的位置相差越大,就意味着在这一对项中,用户点击的项比用户没有点击的项排名靠后,也就是说:列表中的顺序关系是错误的,模型需要在这一对项上进行训练。我们会在后续的aegis推荐中尝试不同的采样策略,然后和大家分享经验。欢迎感兴趣的同学和我们一起探索!
引用[/s2/]
1.http://wnzhang.net/papers/lambdafm.pdf PRFM纸业公司
2.排名评价指标(https://spark . Apache . org/docs/2 . 2 . 0/ml lib-evaluation-metrics . html # ranking-systems)
原文发布于微信微信官方账号——腾讯QQ大数据(qq_bigdata)







