阿里巴巴资深技术专家莫问在2017年12月20日云起会议北京峰会上做了题为《先进的阿帕奇Flink技术》的主题演讲。Apache Flink作为流计算引擎,支持“双十一对”实时计算,已被国内外公司使用。其中“Flink的技术特点”、“阿里巴巴的Flink版本——Blink”和“Blink在实际场景中的应用”等体验都是首次详细分析,非常有价值。
视频内容组织如下:
Apache Flink介绍Flink是继Storm之后的第二个纯流量计算引擎,其特点是支持毫秒级延迟和“至少一次”语义保证。目前阿里巴巴的“双十一”支持每秒4亿次计算。
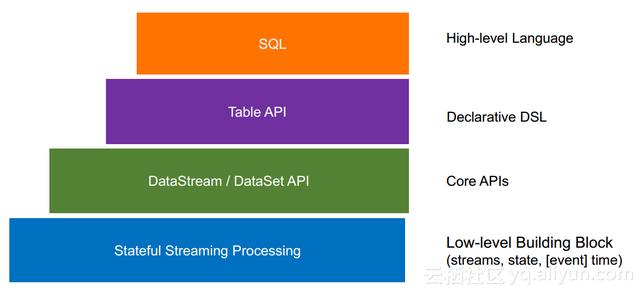
Flink和Storm相比有很多特点。Flink的第一个特点是支持有状态计算。Flink内置状态管理,确保高性能计算和数据的一致性。有了状态,Flink可以提供“恰好一次”的语义。如果业务场景可以接受,也可以支持“至少一次”的语义。状态还支持检查点、恢复、升级、版本等等。
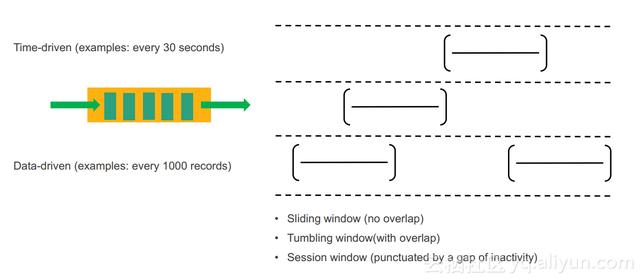
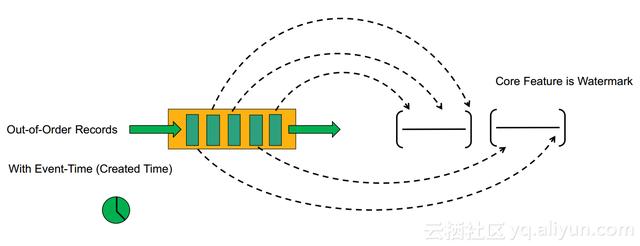
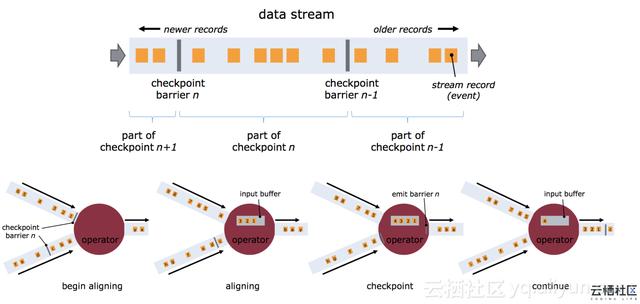
同步检查点会阻碍流量计算,所以采用异步检查点,这样也加快了检查点对齐的速度。持久化检查点的增量会减少I/O的使用,因为Storm会ACK每一条消息,Flink是基于一批消息的检查点,可以保证更好的吞吐量和更好的数据时延。这也是Flink和Storm最大的区别。
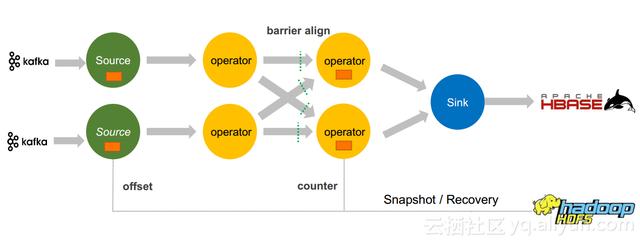
Blink(阿里巴巴Flink版本)是依托阿里巴巴的量产环境和实际需求,对Flink架构进行改进,扩展更多功能的版本。Blink完全兼容Flink的API,并与开源社区无缝对接。目前,Blink团队已经与Flink社区分享了300多个问题,并对一些关键架构和SQL进行了改进。团队培养了5名在社区有良好影响力的弗林克委员。Blink团队连续两年赞助Flink forward大会,每次都是现场分享。
Blink在Flink的基础上进行了五大改造:
1.转换Flink部署和流程模型
Flink以前是独立的部署架构,流程模型和分布式模型都比较小。Blink team按照分布式进程模型的调度也使其能够继续在Yarn和Mesos上运行,解耦其计算和资源调度,改善了规模有限的Flink单主的架构。
2.使用异步I/O模型进行设计
在流计算的过程中,如果一个流卡住了,那么整个流计算都会卡住,这在分布式、高并发的场景下是一个障碍。通过引入异步I/O模型,所有Flink操作符都可以异步访问外部MySQL。短时抖动不会影响整个流的运行,可以大大提高CPU的利用率。
3.完善检查点机制
因为检查点是Flink最大的特点,所以检查点的性能尤为关键。如果做不好,会影响主流程的处理。虽然数据规模很大,但是每分钟只有百分之一的数据更新,做增量检查点会大大降低开销。
4.故障转移的优化
在大规模场景下,实时计算会有成千上万个并发作业,所以一旦发生故障转移,恢复的代价会很大。Blink改进了它。
5.网络层的优化
在流式计算中,网络层的性能非常关键。上行和下行计算都需要网络层洗牌。Blink优化了shuffle的性能,大大提高了网络性能。
阿里巴巴在Flink的SQL上也做出了不少贡献,用流SQL代替了传统的bash SQL。
Flink在阿里巴巴的应用
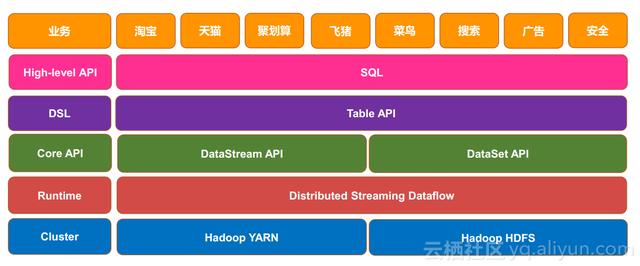
Flink在淘宝的应用案例:
天猫双11成交额实时统计
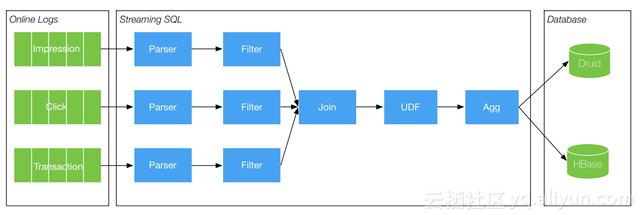
作为一家数据驱动的公司,需要实时监控所有数据。实时计算平台会对这些数据进行处理,呈现给运营商和管理层,让他们根据这些数据做出决策。
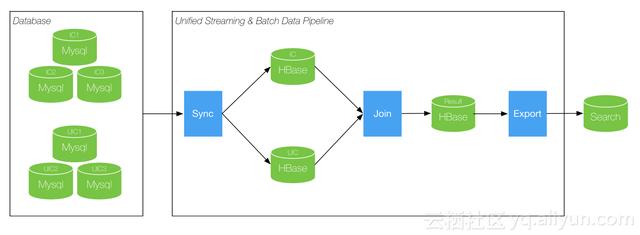
淘宝搜索商品实时更新