
熵,说实话,第一次看到这个词我很惊讶。我听说过智商,情商,财商,甚至失意商。这个熵到底是什么?看字形,左边一个火字,右边一个商字,核对一下。"熵& # 34;代表代代相传,古寺香火不断被称为熵。
相传这个熵字的来源是:1923年,著名物理学家M·普朗克来到南京东南大学讲学。在谈到热力学第二定律及其极其重要的概念熵时,当时的翻译家胡教授把这个复杂而深刻的概念翻译成了“熵”。
熵是什么意思?根据热力学定律,能量只能从一种形式转化为另一种形式,比如风力发电,将风能转化为电能;水力发电就是把水的势能转化为电能。在能量转换过程中,这部分在转换过程中被耗散掉,未被利用的能量就是熵。这个熵就是不可用的能量,从可用的能量到不可用的能量。事实上,能量分布从聚集到均匀分布。我理解这类似于金属矿石中金属含量比较低,提炼起来太麻烦,变得无法使用。这种能量从高度集中,到均匀分布和分散的能量,是一个能量从有序到无序的过程。有序态,低熵,无序态的高熵。看熵的翻译。火这个词旁边的解释与能量有关,火燃烧后,它会变成灰烬和混乱。所以用熵来表示无序的混沌,真是神来之笔。
还有一个更重要的原理,熵增原理:在没有外界影响的情况下,不可用的能量会越来越多,这个过程不能自动逆转。
比如你的房间不整洁,任其改变,只会越来越乱;没有规划的人生,如果只是随波逐流,只会趋于平庸;拼的整整齐齐的积木只会越来越乱;往水里滴一滴墨水。随着扩散,墨水会变得越来越均匀和无序。而这些过程在没有外界影响的情况下是不可逆的。当然,如果你把房间收拾一下,房间会从乱到整齐,从高熵,也就是从低有序度到高有序度,逐渐减少。在这个过程中,房间的熵减小了,但是你也做了一些功,在这个过程中,无序能[熵]还是增加了。
根据这个熵增原理,宇宙在膨胀,然后从有序变到无序,然后从高低温差大变到几乎没有温差,最后走向热寂静状态——一种没有生命和意识的无序状态,然后宇宙就灭亡了。
二 信息熵我们经常听说这个信息量非常大,那么如何衡量信息量呢?我们先来看信息的作用。* *信息是为了让我们对某些事情更加确定。* *举个简单的例子,如果我知道明天股市会涨的信息(里面没有虚假信息),那么股市会涨还是会跌,或者不会涨还是会跌,有三种可能,但是我有了这个信息之后,“明天股市会涨”,股市会涨还是会跌,就由不确定性决定了。
再比如,如果明天太阳出来了,你觉得信息量大还是小?这几乎相当于一句废话,因为明天太阳出来的确定性很大;如果说美国明天要换总统,这句话很有信息量,因为美国换总统是小概率的不确定事件,很多事件变成确定事件,那么这句话很有信息量。
所以,* *信息的大小和这个信息引入之前的不确定性,不确定的东西越多,信息量就越大。* *在热力学中,我们用熵来表示无序能量。在信息论中,伟大的香农提出用信息熵来表示不确定性的大小。不确定性越多,信息熵越大。美国明天就要换总统了,这个信息熵很大。
三 信息量的计算在信息论中,信息的单位是一位,即计算机中的一位。如何计算一条信息的信息量?如果我们在考试,选一个题目,有四个答案(ABCD),如果有小伙伴告诉你答案应该是A,这个信息是多少?从四种不确定的情况到一种确定的情况,按照原理应该是四种,但是在计算机中,四种情况都是用两位数来表示的,所以这个答案的信息量是2位,这就隐藏了一个假设,即四个答案的概率分别相同,都是1/4。香农的祖先将信息量定义为信息熵,计算公式为:
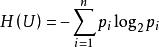
其中Pi代表不同事件的概率。计算这个问题答案的信息量如下:
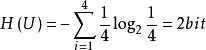
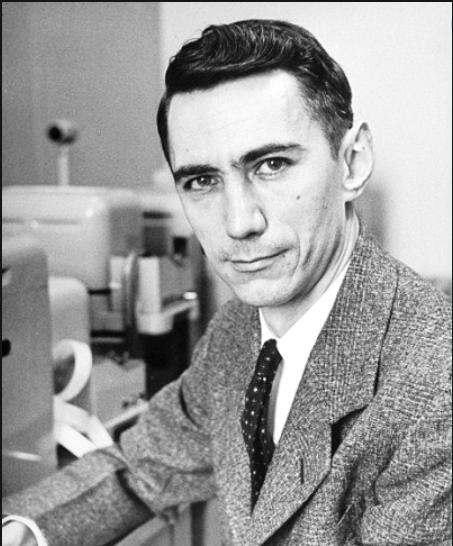
克劳德·香农
四个决策树
决策树是机器学习中一种容易理解的算法。以数据分析实战45为例。如果我们决定是否打篮球,决策条件是:是否晴天,温度和湿度是多少。我们把这个一步一步的思考判断过程画出来,就是一棵树。树的叶子节点是我们最终决定是否打篮球。这棵树就是决策树,因此得名思维,简单来说就是帮助我们做决策的树形图。
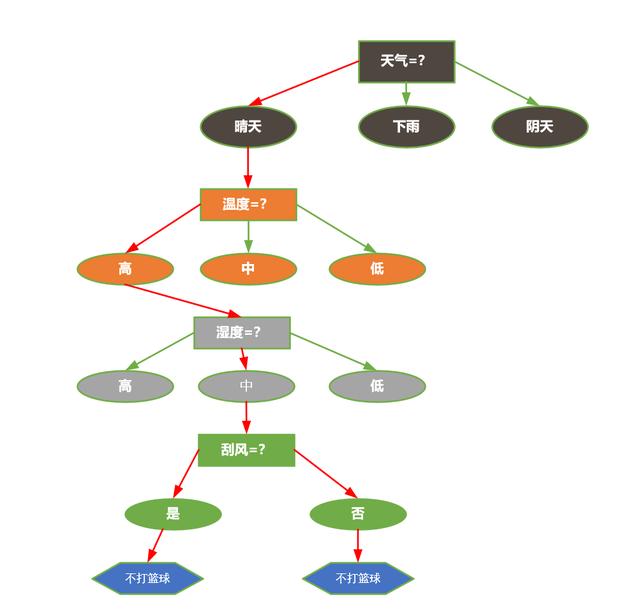
上图只展示了两种最终的决策过程,如果两种都画的话会很难看清楚。决策树算法有两个主要步骤:1 .建立一个决策树。2.修剪决策树。
4.1 构建决策树如何构建这个决策树是关键,哪个条件是根节点,哪个条件是分支。我们可以根据条件建立许多决策树。哪个决策树最好。评判条件是什么?决策树的目的是使决策结果最接近真实最优解,是最准确的结果,哪个决策树就是最优的。
这里引入纯度的概念。所谓纯度是指除法结果更加集中,这个纯度的平均分布最低。45堂实用数据分析课中的例子:
集合:打篮球6次;2: 4次打篮球,2次不打篮球;3: 3次打篮球,3次不打篮球。
在三个划分的集合中,集合1的纯度最高,数据更集中在一个结果中。如果用信息熵表示,纯度高的话信息熵小(因为不确定度低);如果纯度低,比如集合3,那么信息熵就大(因为不确定性程度高)。我们也用文章中的例子计算信息熵:H(集合1) =-6/6*log6/6 = 0 H(集合2)=-4/6 * log4/6+(-2/6 * log2/6)= 0.918295834054896H(集合3) =
当我们建造一棵树时,将基于纯度来建造。如果有多个属性可以作为划分条件,我们使用纯度最高的条件,也就是信息熵最低的条件作为首要条件。以下属性也依次划分。划分不纯有三种算法:信息增益(ID3算法)、信息增益率(C4.5算法)、基尼指数(Cart算法)。
ID3算法所谓信息增益算法,可以理解,如果有很多属性可以作为划分条件,那么我们选择划分前后信息熵减少最大的一个作为当前划分条件,也就是说信息的纯度越高。
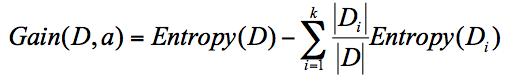
说明:熵(D)表示D属性的信息熵,Di表示子节点。
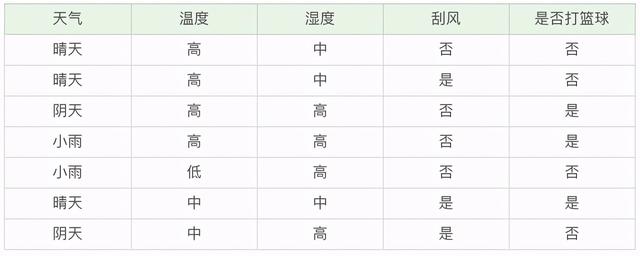
我们的目的是判断今天是否打篮球。因为有两种可能,我们无法确定,所以需要引入信息来降低信息熵。当信息熵降低到零时,我们将最终决定是否打篮球。首先,计算上表中是否打篮球的信息熵:
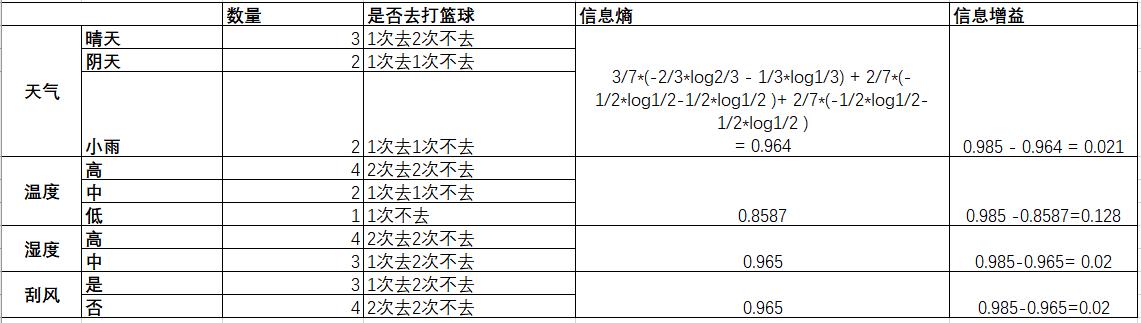
可以看出,温度选择的信息增益最大,所以选择温度作为决策树的根节点。温度选定后,计算温度的信息熵,然后根据天气等重新划分温度的节点。,并分别计算了其余天气、湿度和有风条件的信息增益,此时应减少0.8587。
缺点:
C4.5算法 C4.5采用信息增益率作为划分决策树的依据,信息增益率=信息增益/属性熵;对于属性值较多的情况,信息增益会较大,但属性熵也会较大,所以信息增益率不大。与ID3算法相比的优势:
CART算法 CART使用基尼指数作为生成决策树的基础。假设有K类,样本属于K类的概率为pk,那么概率分布的基尼指数定义为:
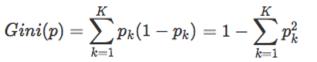
基尼系数类似于熵,比如只有一组结果,那么信息熵计算为0,基尼系数也计算为0。类别分布(0,1)的节点具有零杂质,而平衡分布(0.5,0.5)的节点具有最高杂质。如果用这个公式计算,分布(0,1)的基尼系数为0,分布(0.5,0.5)的基尼系数为1。显然第一套更纯粹。CART是一棵二叉树。每次数据被切成两部分,分别进入左子树和右子树。而且每个非叶节点有两个子节点,所以CART比非叶节点多一个叶节点。与ID3和C4.5相比,CART有更多的应用,既可以用于分类,也可以用于回归。在CART分类中,基尼指数(gini)用于选择最佳的数据分割特征。基尼描述的是纯度,类似于信息熵。购物车计算速度更快。
4.2 决策树剪枝决策树构建完成后,需要剪枝。修剪的目的是防止过度拟合。因为现实中的样本数量是有限的,如果决策树中的属性很多,可以完美匹配测试样本,但是应用到现实环境中,准确率会很低,所以需要剪除对结果影响不大的分支。
剪枝分为前剪枝和后剪枝。预剪枝是在构造树的过程中对分割后的情况进行评估。如果评估后发现这个节点在不增加精度的情况下被划分,就不划分了,直接作为叶子节点处理。后剪枝是指决策树建立后,从叶子节点开始,一步步向上遍历每个节点。如果发现去掉这个节点子树,保留这个节点子树,对整个预测的性能影响不大或者会有所提高,那么这个节点就会被砍掉,被下层出现频率最高的子节点所取代。
引用:







