
今天我就给大家展示一下如何用python直接采集百度指数的数据。
百度指数是基于百度海量网民行为数据的数据分析平台。它可以告诉用户某个关键词在百度有多大,某个关键词在一段时间内的涨跌以及相关新闻舆论的变化,关注这些词的网民是什么样的,分布在哪里,搜索过哪些相关的词。
10%先生分享了如何使用uiautomation采集百度指数:如何批量获取百度指数?
不过个人感觉这种方法好像有点像杀鸡用牛刀。网页用硒完全够用。当然,专门为硒防爬检测设计的网页需要专门修改。
本文不演示如何使用UI自动化工具收集百度指数。为了更容易采集,会直接读取界面进行分析。
关于uiautomation,PC端UI automation可以查看教程:
Https://blog.csdn.net/as604049322/article/details/121391639打开百度索引,发现必须先登录才能查看索引。例如,让我们比较一下python和Java在最近一周的索引:
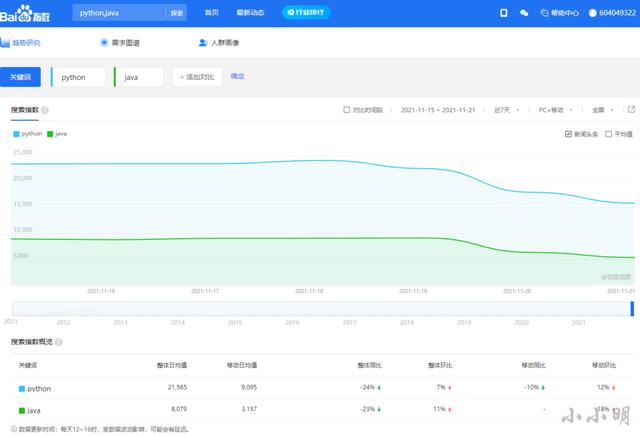
当鼠标移动到每一天的坐标时,会显示当天的数据,例如:
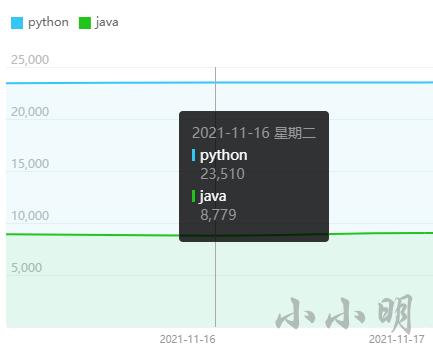
如果我们使用UI自动化,至少我们要模拟移动到每日坐标。
打开开发者工具,再次查询找到获取数据的界面:
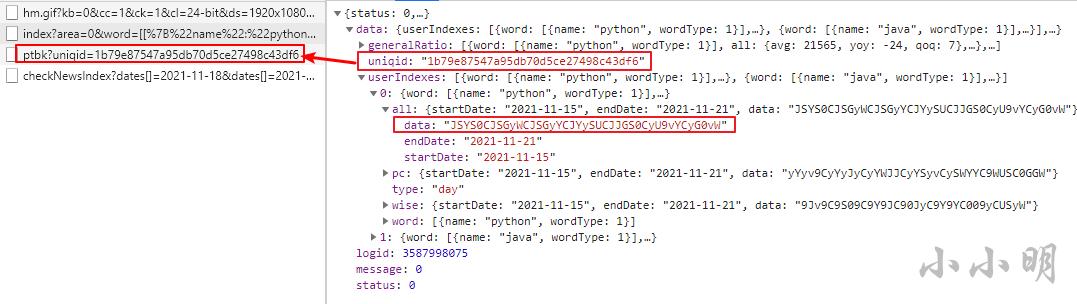
的实际指数数据存储在此数据字段中,但它是以某种加密方式加密的。
然后注意第二个接口的某个参数和当前接口返回的数据的某个值是一致的。
这时,我全局搜索decrypt,找到了加密函数:
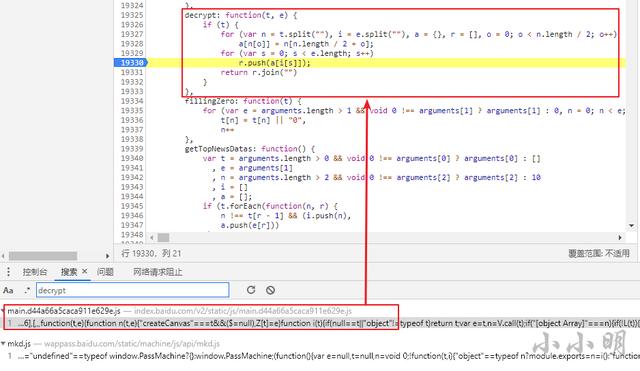
此时,点击断点并再次搜索。可以看到传入该函数的T参数与ptbk接口返回的值一致:
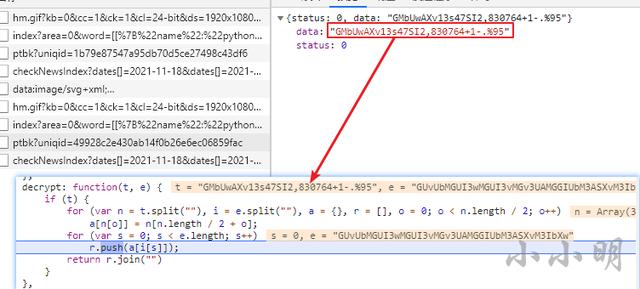
说明我们只需要把这个js翻译成python就可以解密加密的数据了。
下面总结一下指标数据采集的思路:
通过解密函数根据密钥key解密userIndexes。让我们用代码来实现它。首先,我们得到指数数据:
import requestsimport JSON
headers = { " Connection ":" keep-alive "," Accept": "application/json,text/plain,*/*," User-Agent ":" Mozilla/5.0(Windows NT 10.0;WOW64) AppleWebKit/537.36 (KHTML,像壁虎一样)Chrome/86 . 0 . 4240 . 198 Safari/537.36 "," Sec-Fetch-Site": "same-origin "," Sec-Fetch-Mode": "cors "," Sec-Fetch-Dest": "empty "," Referer ":" https://index . Baidu . com/v2/main/index . html "," Accept-Language": "zh-CN,zh;q=0.9 ",' Cookie': cookie,}
words = '[{ " name ":" python "," wordType":1}],[{"name":"java "," word type ":1 }]' start = ' 2021-11-15 ' end = ' 2021-11-21 ' URL = f ' http://index . Baidu . com/API/search API/index?面积= 0 & ampword = { words } & amp面积= 0 & ampstartDate = { start } & ampEnd = {end}' RES = requests.get (URL,headers = headers)Data = RES . JSON[' Data ']数据cookie需要在登录后复制粘贴,也就是请求中的这个字符串(直接复制粘贴即可):
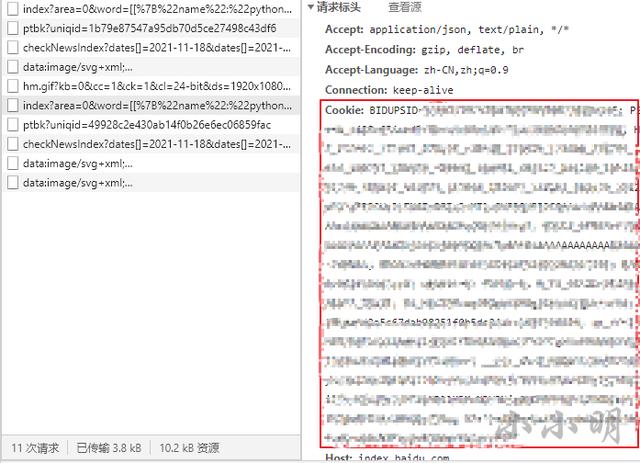
结果:
{ ' user indexes ':[{ ' word ':[{ ' name ':' python ',' wordType': 1}],' all': {'startDate': '2021-11-15 ',' endDate': '2021-11-21 ',' data ':' WQ3Q-nwq . ygnwq . y 3 NW 3 yqsnww . q-nys XV 3 ny。-VG'},' pc': {'startDate': '2021-11-15 ',' endDate': '2021-11-21 ',' data ':' yyvxny 3 ywyny 3 GW wny 3 qyvnyvg 33 nxgsqn-..G'},' wise': {'startDate': '2021-11-15 ',' endDate': '2021-11-21 ',' data ':' XWVXnXQ-xnx 3 xwnx-wynx 3n-XynsQyG ' },' type': 'day'},{'word': [{'name': 'java ',' wordType': 1}],' all ':{ ' start date:' 2021-11-15 ',' endDate': '2021..nXyyGnVQyWn。QQQ'},' pc': {'startDate': '2021-11-15 ',' endDate': '2021-11-21 ',' data ':' . vvvn . 3 xsn . xx3n .-vwn . sw3 nqg-snWVWQ ' },' wise': {'startDate': '2021-11-15 ',' endDate': '2021-11-21 ',' data': 'QW。XnQW-wnqg 3 vnqyxqnqq-vnqww . NWS yg ' },' type': 'day'}],' general ratio ':[{ ' word ':[{ ' name ':' python ',' wordType': 1}],' all': {'avg': 21565,' yoy': -24,' qoq': 7},' pc': {'avg': 12470,' yoy': -32,' qoq': 3},' wise': {'avg': 9095UserIndexes是索引详细数据,generalRatio是概览数据。
下面我们只关心每个关键词的整体表现。
让我们获得uniqid并获得ptbk:
uni qid = data[' uni qid ']RES = requests . get(f ' http://index . Baidu . com/Interface/ptbk?Uniqid = {uniqid} ',headers = headers)ptbk = RES . JSON[' data ']ptbk ' LV . 7yf-s 30 wxgqn . 65+1-874% 2903,'接下来,我将下面的Js代码翻译成python:
解密:function(t,e) { if (t) { for (var n = t.split(" "),i = e.split(" "),a = {},r =,o = 0;o & ltn .长度/2;o++)a[n[o]]= n[n . length/2+o];for(var s = 0;s & lt长度;s++)r . push(a[I[s]]);return . join(" " })Python代码:
Defdecrypt (ptbk,index _ data):n = len(ptbk)//2a = dict(zip(ptbk[:n],ptbk [n:])) return "。join([a[s]for s in index _ data])
for user indexe in data[' user indexes ']:name = user indexe[' word '][0][' name ']Index _ data = user indexe[' all '][' data ']r = decrypt(ptbk,Index _ data) print (name,r)
Python 23438,23510,23514,24137,22538,17964,15860 Java 8925,8779,900
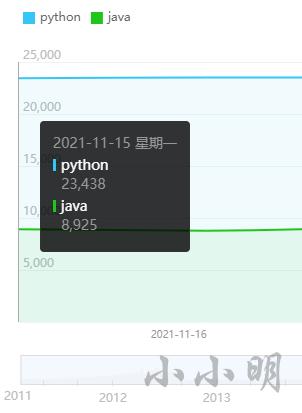
那么我们就可以很容易的得到任意指定关键词的索引数据。我将它封装成一个整体,完整的代码是:
导入请求导入jsonfrom datetime导入日期,time delta
headers = { " Connection ":" keep-alive "," Accept": "application/json,text/plain,*/*," User-Agent ":" Mozilla/5.0(Windows NT 10.0;WOW64) AppleWebKit/537.36 (KHTML,像壁虎一样)Chrome/86 . 0 . 4240 . 198 Safari/537.36 "," Sec-Fetch-Site": "same-origin "," Sec-Fetch-Mode": "cors "," Sec-Fetch-Dest": "empty "," Referer ":" https://index . Baidu . com/v2/main/index . html "," Accept-Language": "zh-CN,zh;q=0.9 ",' Cookie': cookie,}
def decrypt(ptbk,index _ data):n = len(ptbk)//2a = dict(zip(ptbk[:n),ptbk[n:])) return " "。join([a[s]for s in index _ data])
def get _ index _ data(keys,start=None,end=None): words = [[{"name": key," word type ":1 }]for key in keys]words = str(words)。替换(" "," ")。替换("'"," " ")today = date.today如果start为None:start = str(today-time delta(days = 8))如果end为None:end = str(today-time delta(days = 2))
URL = f ' http://index . Baidu . com/API/search API/index?面积= 0 & ampword = { words } & amp面积= 0 & ampstartDate = { start } & ampendDate={end}' print(words,start,end) res = requests.get(url,headers = headers)data = RES . JSON[' data ']uniqid = data[' uniqid ']URL = f ' http://index . Baidu . com/Interface/ptbk?uni qid = { uni qid } ' RES = requests . get(URL,headers = headers)ptbk = RES . JSON[' data ']result = { } result[" start date "]= start result[" end date "]= end for user indexe in data[' user indexes ']:name = user indexe[' word '][0][' name ']tmp = { } index _ all = user indexe[' all '][' data ']index _ all _ data =[int(e)for e in decryptsplit(",")tmp[" all "]= index _ all _ data index_pc = user indexe[' PC '][' data ']index _ PC _ data =[int(e)for e in decrypt(ptbk,index _ PC)。split(",")tmp[" PC "]= Index _ PC _ data index_wise = user indexe[' wise '][' data ']Index _ wise _ data =[int(e)for e in decrypt(ptbk,Index _ wise)。split(",")tmp[" wise "]= index _ wise _ data result[name]= tmp返回测试结果:
get_index_data(["python "," Java "]){ ' start date ':' 2021-11-15 ',' endDate': '2021-11-21 ',' python': {'all': [23438,23510,23514,24137,22538,17964,15860],' pc': [14169,14121,14022,14316,14316
本文来自小明的博客,原文链接:
https://blog.csdn.net/as604049322/article/details/121490054







