
作者:余敦刚(苏宣)
命名是对事物本质的认知探索,是对读者有价值的承诺。不好的命名会像雾一样,把读者引入深渊;好的名字会像灯塔一样,照亮读者前进的道路。名字太奇妙了,本文将一步步揭开它的神秘面纱!
命名来源生活
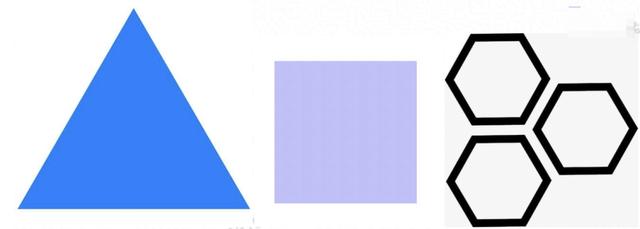
从左到右:正三角形、正方形和正六边形代表边长等。,因此正XXX的边长必须相等。
这些东西的特点很明显,容易被人记住。但也有一些难以命名,如化学有机物:
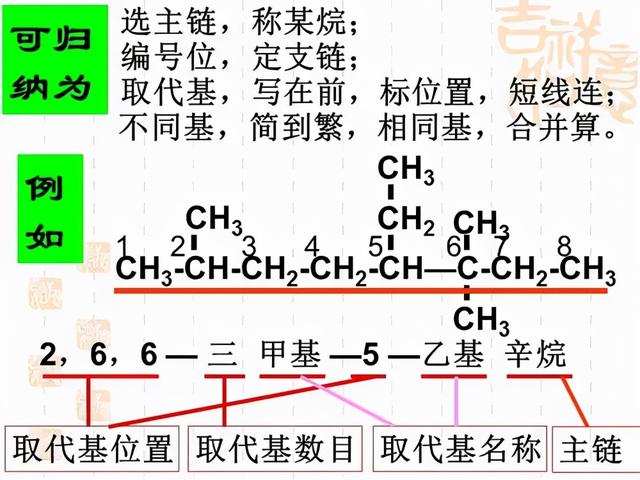
与化学有机物相比,软件世界里的东西更多,命名会更困难。
菲尔顿(Phil Karlton)曾经说过:计算机科学只有两个难题:缓存失效和命名约定。
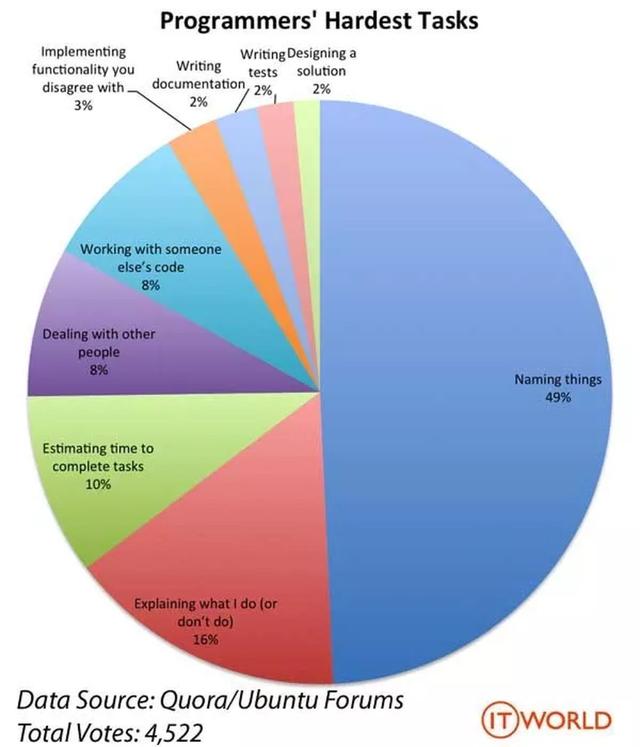
命名一直是软件领域的一个难题。好的命名可以是忠实的、富有表现力的和优雅的:
三难:信达雅。
——严复
信:准确的意思
达:通顺流畅
雅:简洁优雅
看下面的代码,说出它的意思:
公共列表& ltint[]>getThen(){ List & lt;int[]>list1 =新数组列表& ltint[]>(); for(int[]x:the list) if(x[0]= = 4) list 1 . add(x); 返回列表1; }问题不在于代码的简明性,而在于代码的模糊性:即代码中没有清晰反映上下文的程度。
问题的答案并没有反映在代码片段中,但是它们应该在那里。
再次查看重命名后的代码:
公共列表& ltint[]>getFlaggedCells(){ List & lt;int[]>flaggedCells = new ArrayList & ltint[]>(); for(int[]cell:game board) if(cell[STATUS _ VALUE]= = FLAGGED) FLAGGED cells . add(cell); 返回flaggedCells }注意代码的简单性没有被触动。运算符和常数的数量保持完全不变,嵌套的数量保持完全不变。但是代码已经变得清晰多了。
站在用户的角度,能不能更进一步?
尽管名称getFlaggedCells表明该方法将返回FlaggedCells,但返回的数据结构并未表达:
公共列表& ltCell & gtgetFlaggedCells(){ List & lt;Cell & gtflaggedCells = new ArrayList & ltCell & gt(); for(Cell Cell:game board) if(Cell . isflag()) flagged cells . add(Cell); 返回flaggedCells }你能看出代码中的两个区别吗?
如果你仔细看,你会发现有两点得到了改进:
只需更改以下名称,您就可以很容易地知道发生了什么。这就是命名的力量。
命名的游戏首先,我们来玩一个游戏,叫做“我们住在哪个房间?”下面给大家提供一张图。请告诉我这是什么房间。
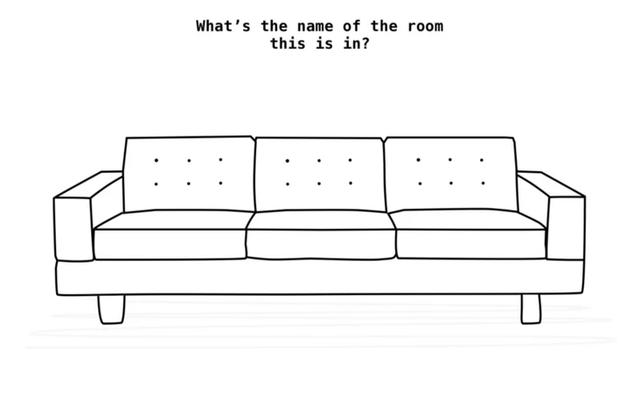
从上图不难看出,这一定是客厅。基于一个物品,我们可以联想到一个房间的名字,这个很简单,请看下图。
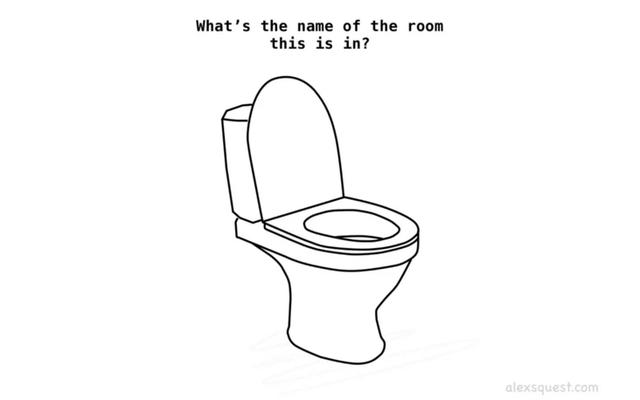
根据这张图片,我们可以肯定地说,这是厕所。通过上面两张图不难发现,房间名称只是一个标签属性。有了这个标签,我们甚至不需要看里面有什么。这样,我们可以建立第一个推论:
推论1:容器(函数)的名字应该包含它的所有内部元素
如果有床。然后是卧室。我们也可以反过来分析。
问题:根据一个容器名,我们可以推断出它的组件。如果以卧室为例,这个房间很有可能有一张床。这样,我们可以建立第二个推论:
推断二:根据名称推断容器(函数)的内部组件
现在我们有两个推论,根据这两个推论我们试着看看下图。
问题3/3
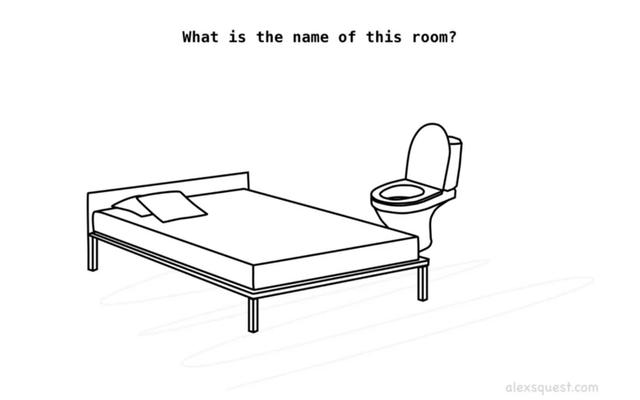
好吧,床和马桶在同一个房间?根据我们的推断,上图让我们很难立刻做出判断。如果还是用上面两个推论来定义的话,那我就叫它怪物的房间。
问题不在于同一个房间的物品数量,而在于完全不相关的物品被视为具有相同的标签属性。在家里,我们通常把意图和功能相似的相关事物放在一起,以避免混淆,所以现在我们有了第三个推论:
推论三:容器(函数)的清晰程度与其内部组件的紧密程度成正比
这可能很难理解,所以我们用下图来说明:
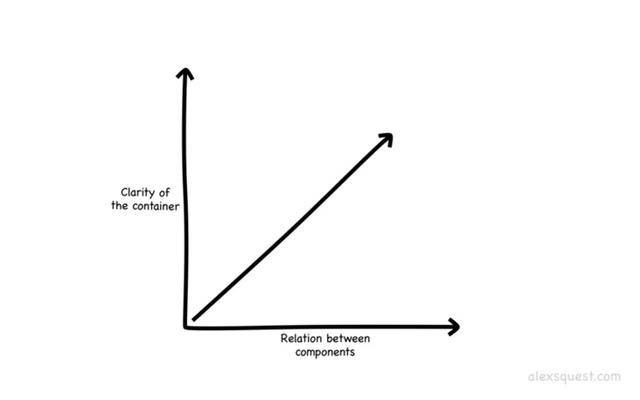
如果容器内部元素的属性紧密相关,那么更容易找到一个名称来解释它。相反,元素之间的不相关性越强,就越难以描述。
属性维度可能与其功能、目的、策略、类型等有关。至于命名标准,需要和元素本身的属性相关,才有实际意义。
这个观点也适用于软件工程。比如我们熟悉的组件、类、函数方法、服务、应用。罗伯特·德朗奈曾说:“我们的理解能力很大程度上与我们的认知有关。”那么,在这种技术背景下,我们的代码能否让读者以最简单的方式感知业务需求和相关诉求呢?
命名的原则名副其实
名字应该描述它所做的一切(或者它的意图)。
读者在阅读上面这个名为恶趣味的例子中的getThen()时,无法理解getThen()的用意是什么。要得到什么?GetFlaggedCells()可以更准确地表达。
//年糕的命名 Public list < int[]>getThen(); //好名字 公共分发名单< Cell & gtgetFlaggedCells(); //年糕的命名 private Date user cache time; //好名字 私人约会customerstaytotaltime避免误导
避免留下虚假线索来隐藏代码的本意。
单词列表对程序员来说有着特殊的意义。如果装账的容器不是真实的单子,就会导致判断错误。最好使用accountGroup或bunchOfaccounts,甚至accounts。
这种拼写方式很容易误导读者或者让他们花更多的力气去识别。
有意义的区别
如果同一个作用域内有多个名字,最好区分开来。
public static void copy chars(char a1[],char a2[]){ for(int I = 0;我& lta1 .长度;i++){ a2[I]= a1[I]; } }这里参数a1和a2是根据含义命名的,并没有正确的信息或提示作者的意图。
如何进行有意义的区分?
如果将参数更改为source和destination,则此函数的命名更适合其用途。
public static void copy chars(char source[],char destination[]){ for(int I = 0;我& ltsource .长度;i++){ 目的地[i] =源[I]; } }准确使用对仗可以提高命名的区分度。
命名时,遵循对立词的命名规则有助于保持一致性,这也可以提高可读性。像first/last这样的矛盾很好理解;像FileOpen()和_lclose()这样的组合是不对称的,容易混淆。以下是一些常见的对立短语:
info和data的含义过于宽泛,导致没有多余的信息,反而增加了读者的阅读成本,得不偿失。
一贯的风格
保持同一项目中代码命名规则的统一。
例如:
/** *用户名 */ Public Sring用户名; /**用户名**/是抽象且一致的
使同一作用域内的变量或方法具有相同的抽象。
公共类雇员{ ... 公共字符串getName(){...} public String get address(){...} public String getwork phone(){...} public boolean isjobclassificationvalid(jobclassificationjobclass){...} public boolean iszip code valid(Address Address){...} public boolean isPhoneNumberValid(phone number phone number){...} public SQL query getQueryToCreateNewEmployee(){...} 公共SQL查询GetQueryTomodifyemployee () {...} 公共SQL查询GetQueryTomodifyemployee () {..} ... }看看这个类,看看它有多少级抽象。
您可以通过功能名称查看:
不同层次的方法会让这个类看起来很奇怪,就像把晶体管、芯片零件、手机放在一个桌子上。
公共类雇员{ ... 公共字符串getName(){...} public String get address(){...} public String getwork phone(){...} [/ H/]公共字符串创建雇员(...) {..} 公共字符串更新雇员(...) {..} 公共字符串删除雇员(...) {...}
如果你在一个项目中找到一段集合搜索标准的代码,它会在许多地方重复。这个搜索条件比较复杂,以元数据的形式存在于数据库中,所以组装过程如下:
//获取默认搜索条件 列表< String & gtdefault conditions = searchconditioncachetunnel . getjsonquerybylabelkey(label key); for(String JSON query:default conditions){ JSON query = JSON query . replace all(search constants。SEARCH _ DEFAULT _ public sea _ ENABLE _ TIME, string . value of(system . current TIME millis()/1000)); jsonquerylist . add(JSON query); } /取主搜索框的搜索条件 if (string utils。不为空(cmd。getcontent ())) { list
简单分析,不难发现,这里我们遗漏了两个概念:一个是用来表示搜索条件的类——搜索条件;另一个是用来组装搜索条件的类——SearchConditionAssembler。只有对这两个概念进行命名和明确表达,才是完整的重建。
重构后,搜索条件的组装会变成非常简洁的形式,几十次复用只需要引用SearchConditionAssembler。
公共类SearchConditionAssembler { 公共静态SearchCondition assemble(String label key){ String jsonSearchCondition = getJsonSearchConditionFromCache(label key); search condition sc = assembleSearchCondition(jsonSearchCondition); 返回sc; } }可见提取重复代码只是我们重构工作的第一步。抽象出重复码的概念,找到有意义的名称,是我们工作的重点。
所以,每次遇到重复的代码,都要兴奋起来,想,这是锻炼自己抽象能力的绝佳机会,除了测试代码。
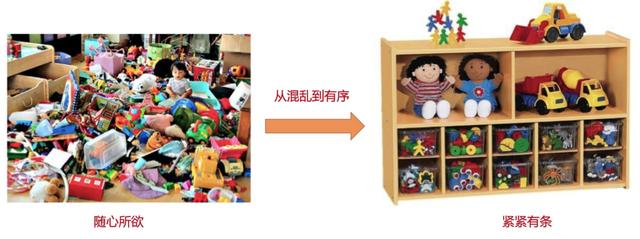
上下文泛化
如果你用的名字来自冷门的语境,比如俚语或者俚语,不知道这个语境的人会很难理解它的意思。
比如用whack识别kill,用wsBank识别网商银行。
如果不能用程序员熟悉的术语来命名,就用涉及到的问题领域的名称,至少维护代码的程序员可以咨询领域专家。至少这样一来,问题领域的专家可以清楚地理解开发者命名的上下文,读者可以向领域专家请教,或者查询领域词汇的含义。
以消息中间件领域为例:主题、消息、标签、偏移量、提交日志。
改名
如果子例程名、类名和变量不明确或命名错误,则需要重命名或重新构造该变量。
更改函数声明
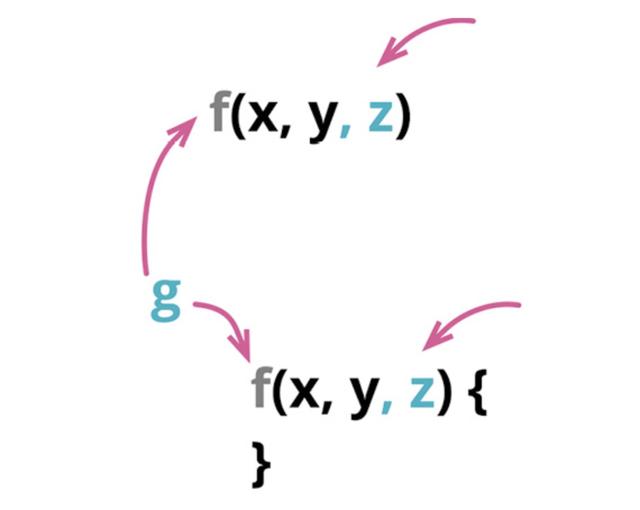
好的名字可以让读者一眼看出函数的用途,而不必查询实现代码。
1动机
功能名称:
改进函数声明的技巧:首先写一个注释,描述这个函数的用途,然后把这个注释变成函数的名字。
函数的参数:
函数的参数表说明了函数是如何与外界共存的,这是函数和函数用户共同的依赖,实际上是一种耦合。
如何选择正确的参数没有简单的规则,要看具体情况。
练习2
常用的重构方法有两种:简单方法和迁移方法。
简单方法:适用于一步修改函数声明及其所有调用方。
最好把大的修改拆分成小的步骤,所以如果要修改函数名和添加参数,最好分两部分来做。幸运的是,简单的方法通常可以用IDE工具直接重构。
实战:以下功能名称太短。
public long circumn(long radius){ return 2 * Math。PI *半径; }将此名称更改为更有意义的名称:
公长周长(长半径){ 返回2 *数学。PI *半径; }迁移途径:函数在很多地方被调用,修改不容易,或者是要修改的多态函数,或者函数声明修改复杂。
实战:还是刚才那个把circum方法改名的例子。
暂时不修改这个简短的函数名。
public long circumn(long radius){ return 2 * Math。PI *半径; }再次添加周长函数:
公长周长(长半径){ 返回2 *数学。PI *半径; }逐步将circum方法的调用地点改为circumference方法,每次修改都要运行测试;如果测试成功,提交此修改进行修改;否则,返回上一步,再次进行修改。这样如果中间出了问题,也能准确定位某个修改,稳定推进重建,间接提高重建效率。
变量已重命名
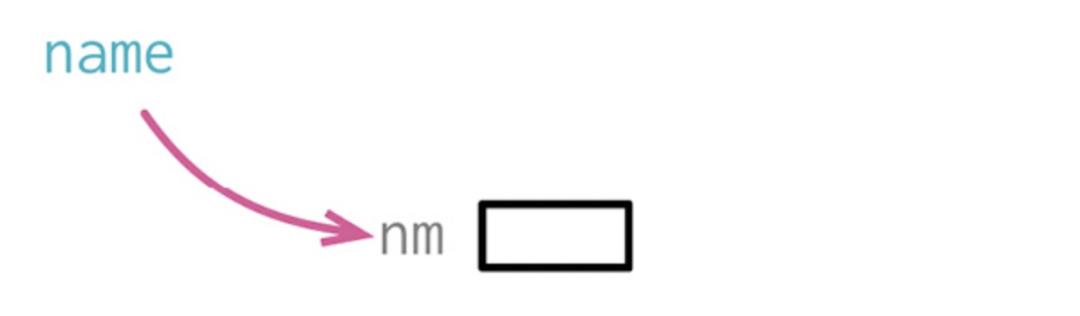
1动机
一个好的变量名可以解释一个程序做什么——如果变量名起得好的话。
2机制
A.如果该变量在另一个代码库中使用,则为“已发布变量”,此时不能进行此重构;
B.如果变量值从不修改,可以复制到一个新的名称,然后逐个修改使用代码,每次修改后执行测试;
3.测试。
3示例
如果要重命名的变量只作用于一个函数,重命名是最简单的,直接用IDE重命名即可。
如果变量不作用于单个函数,那么重命名的风险就不容易控制,所以需要对变量进行封装。
变量初始化
int treeName = & # 34无标题& # 34;;变量被修改。
treeName = & # 34大树& # 34;;读取更改
leftTree = treeName这时候可以考虑用封装变量来完成。
private int treeName public void init(){ treeName = & # 34;无标题& # 34;; } public String get treeName(){ return treeName; } public void setTreeName(String treeName){ this . treeName = treeName; }命名过程命名是一个迭代的过程。当你久久想不出更好的名字时,不要陷入命名的陷阱。您可以先用一个折衷的名称提交或重构这个程序。当你想到一个更合适的名字时,不要犹豫,重建它。
命名是一个接近描述事物本质的过程。名字越好,越容易描述事物的本质。
选择一个好名字最困难的部分在于需要好的描述技巧和共同的文化背景。
结语好的命名是不言自明的,读者可以在不知道程序实现细节的情况下知道程序实现(契约式编程)的意图。在实际项目中,有时很难为一个子程序取一个更好的名字。这实际上是程序在说话——让我做的事情太复杂了,我都不知道自己在做什么。一般来说,需要重新构建这个子程序,在对齐和分而治之中划分职责。命名是一门艺术,美在于简单,美在于清晰,美在于名副其实。
参考文件
https://medium . com/hacker noon/software-Complexity-Naming-6e 02 e 7 E6 c8 CB
关注【阿里巴巴移动科技】微信微信官方账号,每周写3篇移动科技实务&干货供你思考!







